
EchoForge:用空间音频分析在 Unity 中程序化生成可解释的 3D 场景
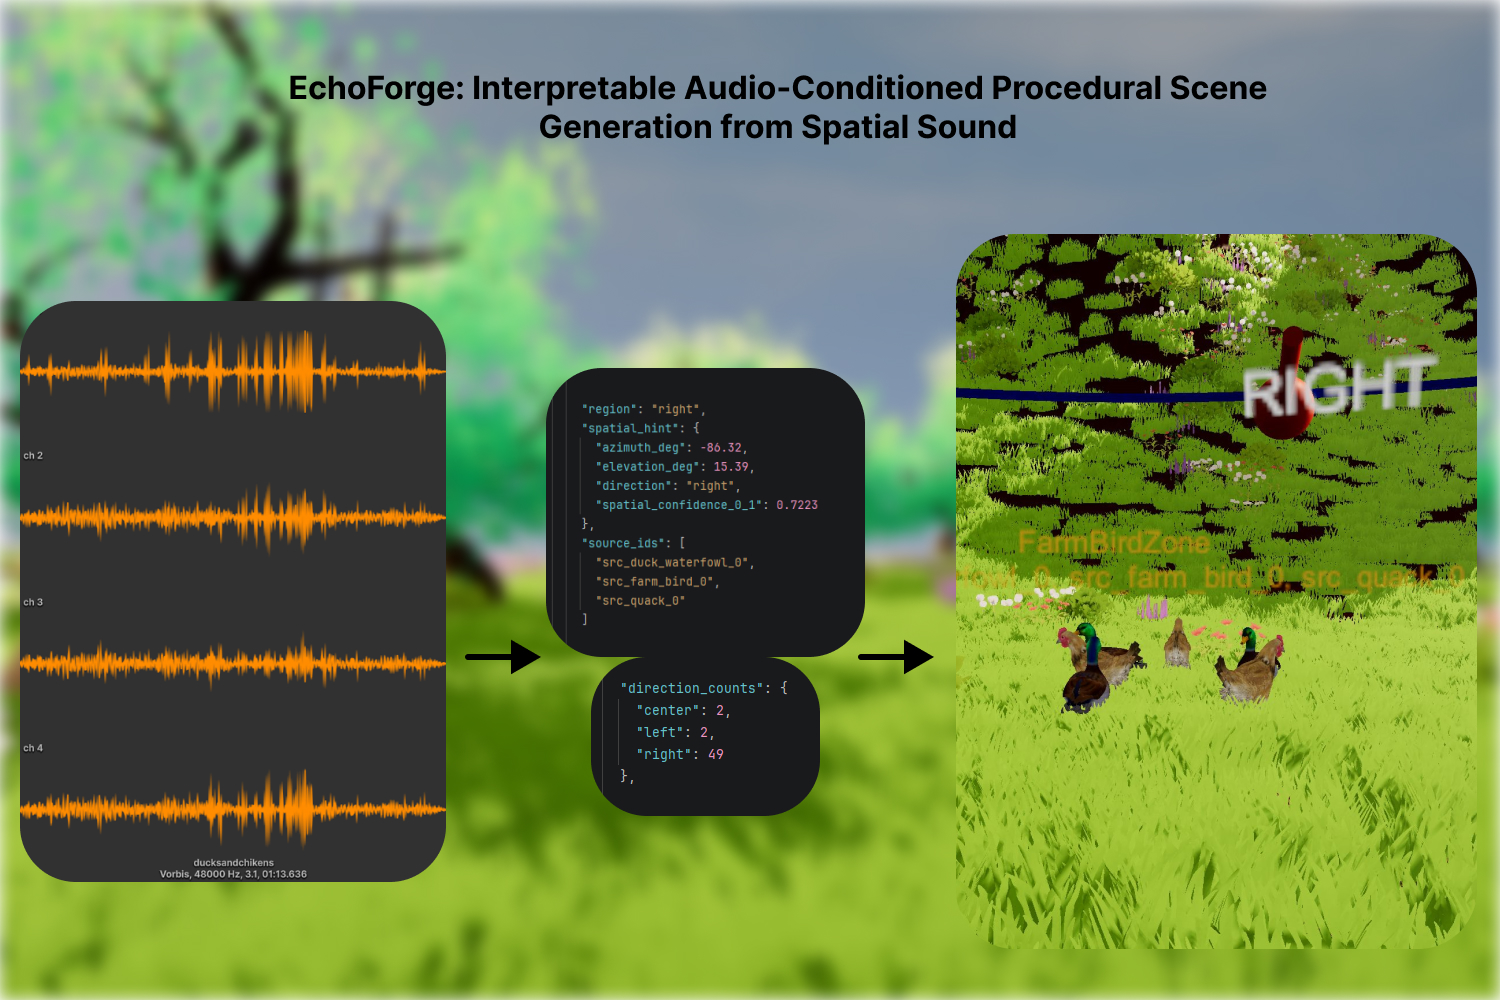
编者按:大多数 3D 场景生成系统都从明确的视觉描述开始,无论这种描述是通过文本、参考图像还是草图提供的。EchoForge 探索了一个截然不同的起点:那些本身就能向听者暗示环境的声音。
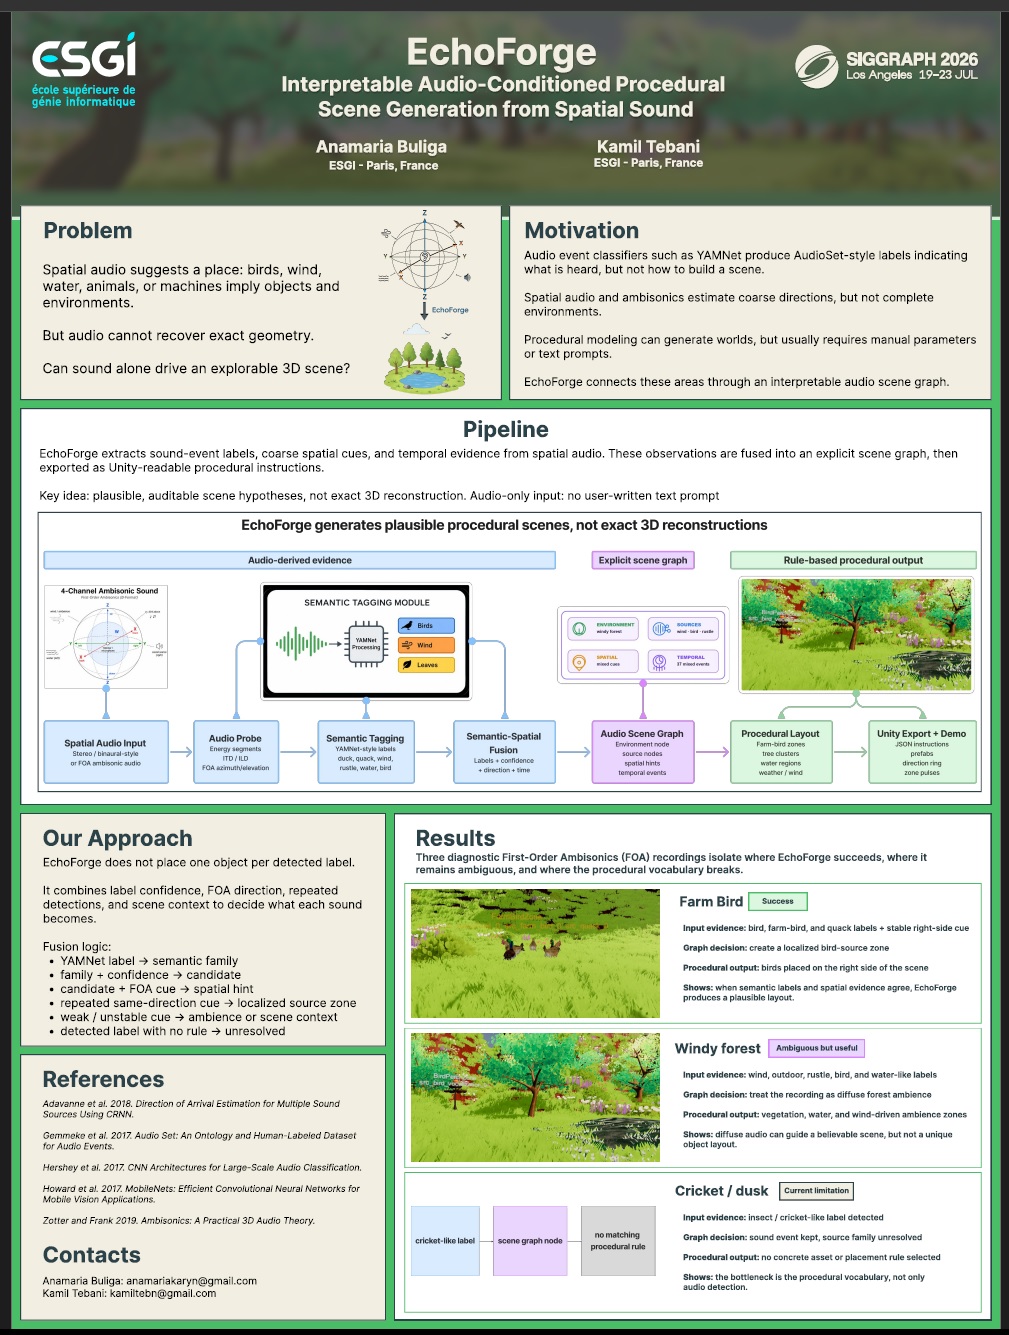
EchoForge 由 ESGI 的学生 Anamaria Buliga 和 Kamil Tebani 开发,它分析空间录音以识别声音事件、估计其大致方向,并推断它们可能描述的更大环境。在为 Unity 中的程序化 3D 环境生成布局指令之前,它将这些证据组织成一个可解释的音频场景图。该项目在 SIGGRAPH 2026 上展示,并在 ACM 学生研究竞赛的本科生类别中获得第一名。
图片来源:Anamaria Buliga 和 Kamil Tebani 的 EchoForge,2026 年
引言
我叫 Anamaria Buliga,是巴黎 ESGI 的硕士研究生,专业方向为计算机图形学、XR 与交互系统。我的工作围绕实时 3D 与沉浸式技术展开,尤其关注程序化生成、仿真、空间计算以及面向 3D 内容的生成式 AI。我喜欢构建将技术研究与交互式视觉体验连接起来的系统,特别是当它们涉及生成或理解 3D 环境的新方式时。我目前从事 XR、沉浸式 3D 生成以及生成式 3D 方法评估方面的研发工作。
我与 Kamil Tebani 共同开发了 EchoForge,他同样在巴黎 ESGI 学习 3D/VR 工程。在转向工程与实时 3D 之前,他曾在 Université Paris Nanterre 学习两年表演艺术,主攻戏剧与电影。如今他的工作介于研究、工程与技术美术之间,尤其热衷于把最初可能显得理论化的想法,转化为能在实时引擎中真正被体验的系统。
EchoForge 处于空间音频、程序化世界生成与可解释 AI 系统的交汇点。该项目在 SIGGRAPH 2026 Posters 上展示,并在 ACM 学生研究竞赛本科组中获得第一名。
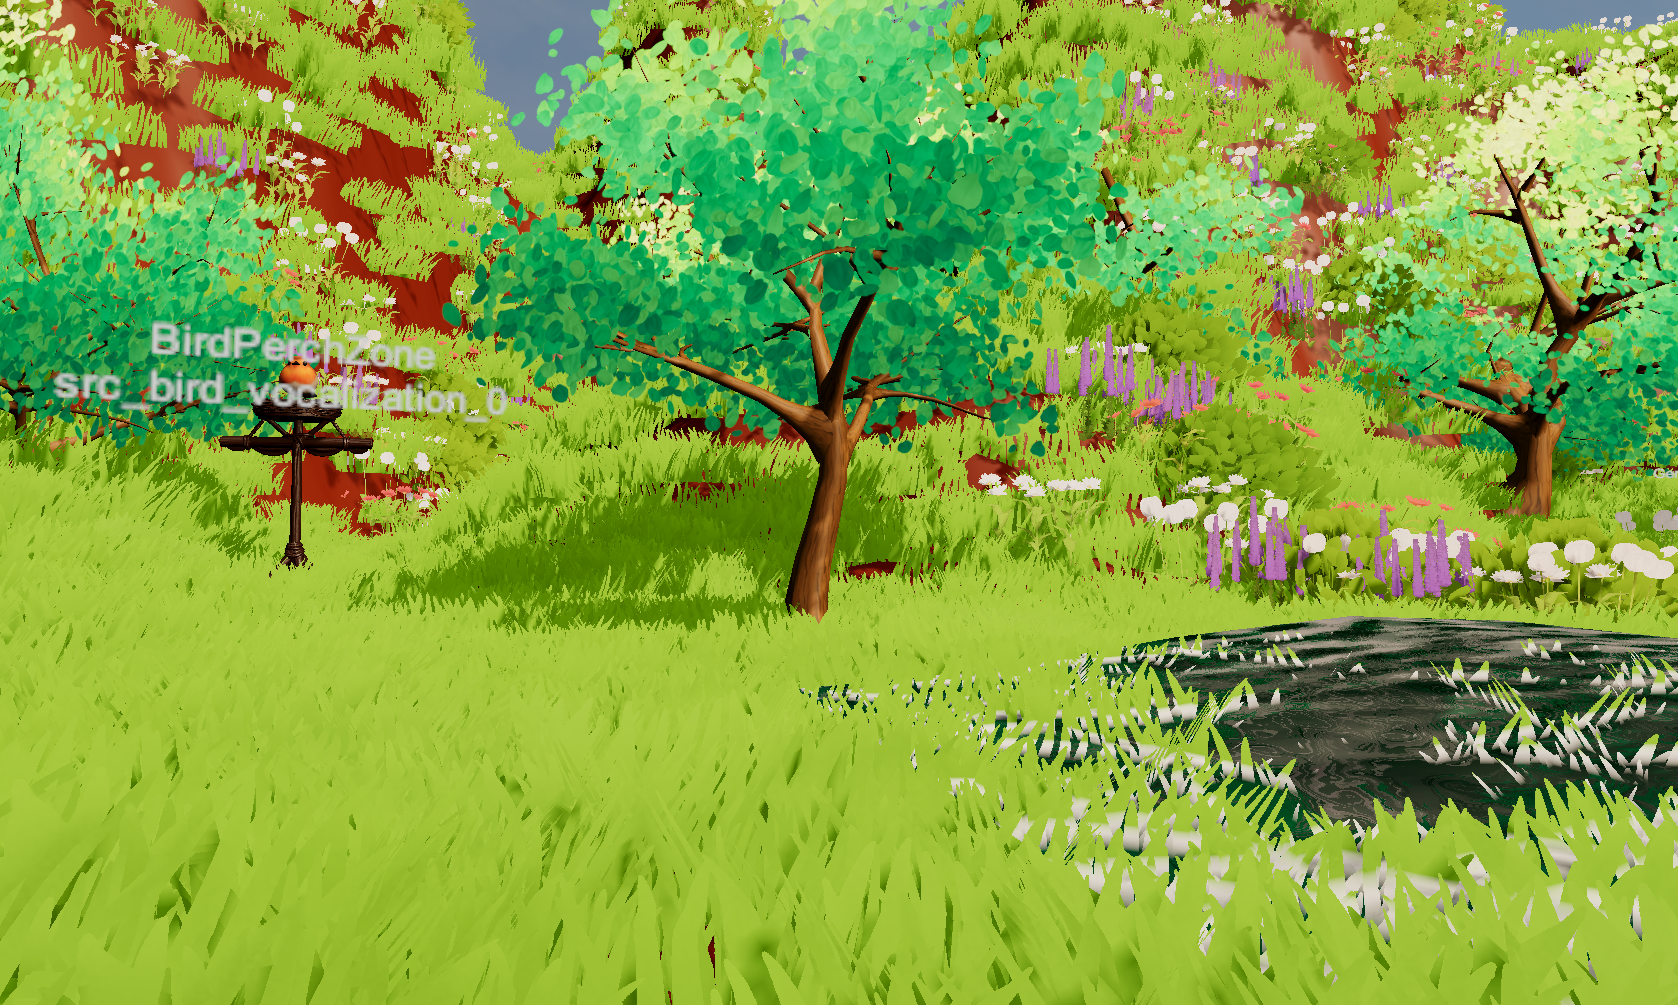
图片来源:Anamaria Buliga 与 Kamil Tebani 的 EchoForge,2026
EchoForge 的灵感
我一直以一种非常视觉化的方式体验声音。当我聆听音乐或环境音频时,我会自然而然地想象出与所听内容相关的场景、地点、动作和视觉元素。声音往往几乎立刻就能在脑海中构建出一幅画面。
这种感知音频的个人方式成为了 EchoForge 背后的部分动机。它提出了一个问题:一个系统是否也能以声音本身作为起点,来构建对环境的视觉解读?
声音本身已经包含了一种“隐藏的场景描述”。当我们听到鸭子、风声、海浪、鸟鸣、树叶沙沙声或交通噪音时,我们自然会开始想象一个地点。与文字或草图不同,声音还携带时间和空间信息:某个声音可能在一侧更响、随时间移动、感觉弥散,或者暗示距离和围合感。
大多数场景生成工具从明确的视觉或文本意图开始。借助 EchoForge,我们想探索录音本身能否成为生成 3D 场景的起点。
目标不是精确重建,因为仅凭音频无法揭示环境的精确几何结构。相反,EchoForge 会创建一个可解释的场景假设:可能存在哪些声源、它们暗示了什么样的环境、它们可能位于何处,以及系统对这些判断的置信度如何。
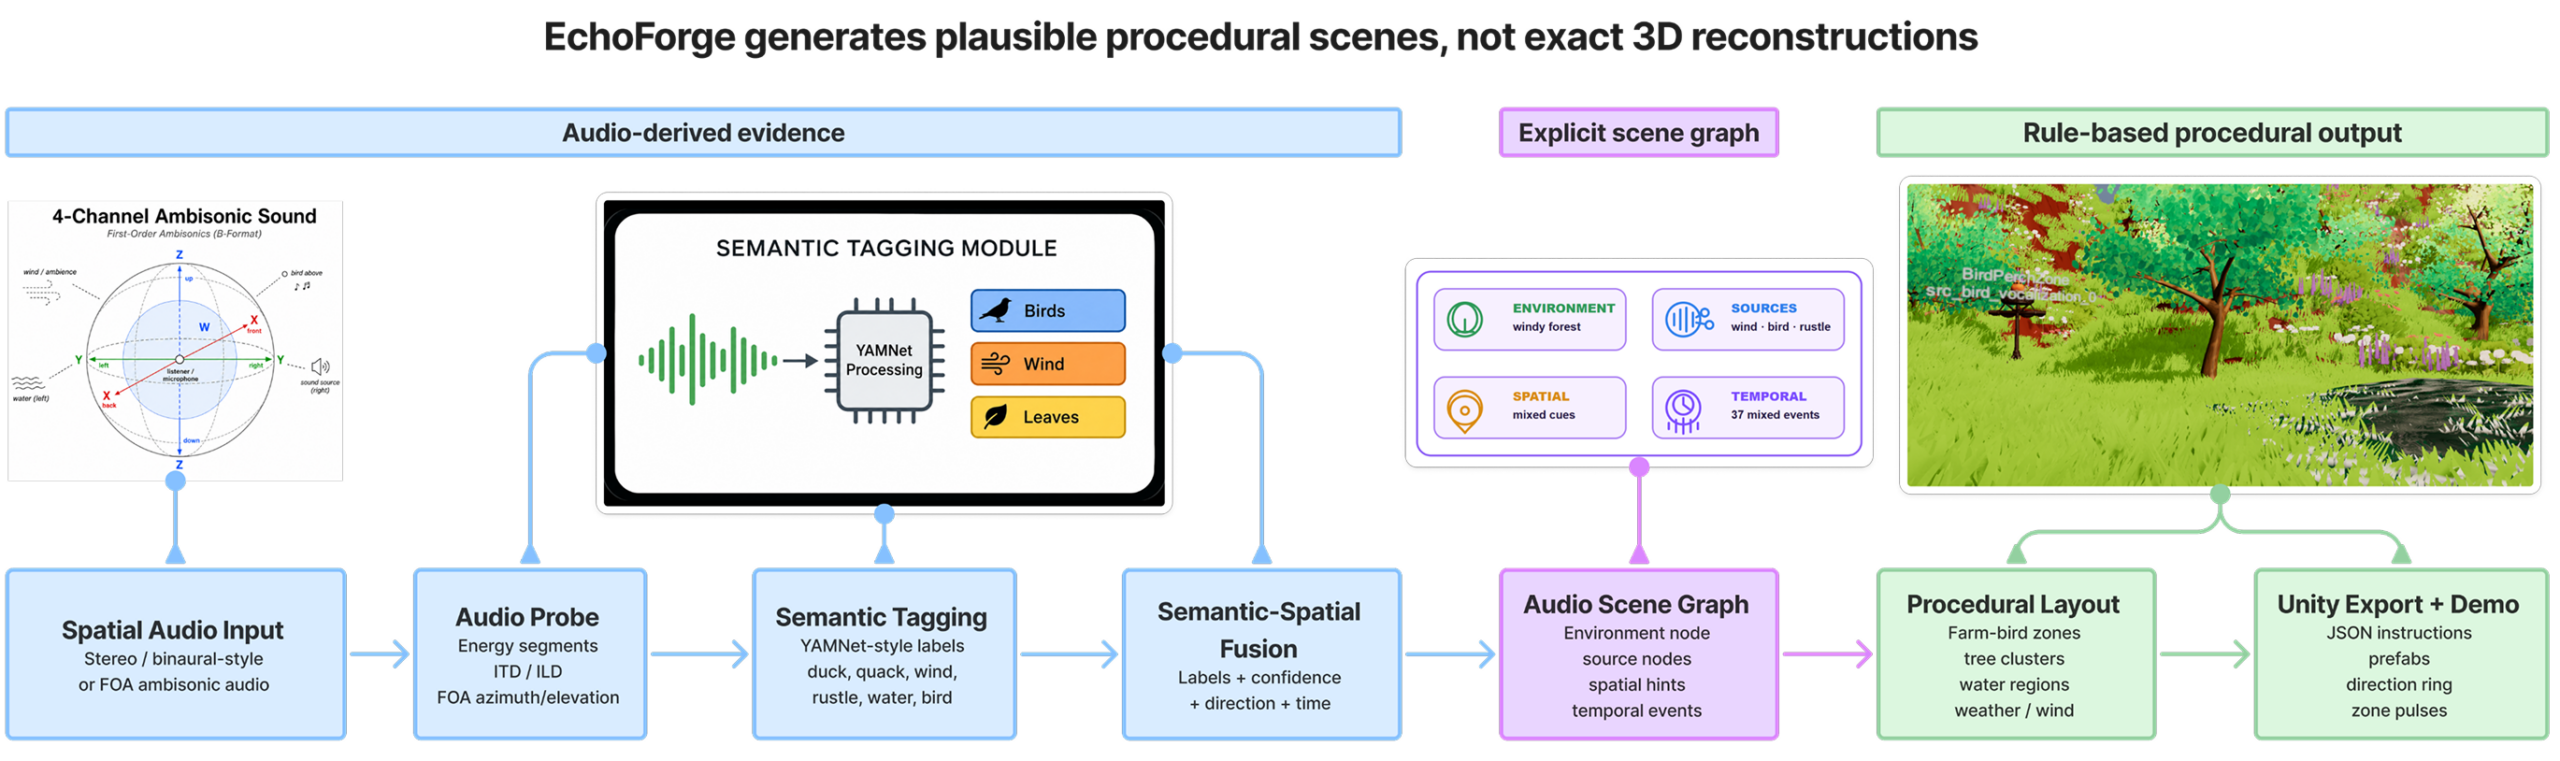
图片来源:Anamaria Buliga 和 Kamil Tebani 的 EchoForge,2026 年
EchoForge 的工作原理
EchoForge 从一段空间音频录音开始。流程的第一部分分析录音中的空间线索,以估计粗略的声源方向、活跃时间段和置信度值。
与此同时,YAMNet 通过 AudioSet 类别用于语义声音事件识别。这为我们提供了对应于鸟、鸭、昆虫、风、沙沙作响的植被或水等事件的标签。
随后,语义信息和空间信息被融合。相关检测结果不会被当作每一个分类器标签独立对待,而是被分组为更高层级的语义家族,例如森林、水、风、鸟鸣、水禽或昆虫环境音。
核心表示就是我们所说的音频场景图。它包含推断出的环境、候选声源、置信度值、空间证据、时间方向信息、关系以及一致性检查。
这种表示很重要,因为它使生成过程保持可解释性。一个视觉决策可以追溯到录音中发现的证据,或者追溯到明确的程序化规则。
最后,场景图被转换为 Unity 可读取的布局指令。这些指令决定诸如地形、植被簇、水域、声源区域、环境氛围和代表性物体等元素。随后,生成的场景可以在 Unity 中实例化并探索。
一个重要的区别是,EchoForge 并不声称能够还原物体的精确位置或物理尺度。相反,它会根据现有证据估算出一个合理的程序化放置位置。
方向来自录音中的空间信息。当某个语义检测结果反复与一致的方向相关联时,系统可以将其转化为所生成环境中对应的声源区域。
尺度与视觉呈现则由程序化规则决定,而不是通过直接的声学测量得出。例如,鸟鸣可能会激活树木和高处的栖息区域,而鸭子或嘎嘎叫声则可能生成地面高度的水禽区域。风被视为环境氛围,而不是一个局部化的物体。
全局语境通过综合多个检测结果推断得出。风声、树叶沙沙声、鸟鸣和其他户外声音可以共同支持一个森林般的环境,而与水禽相关的声音则可以支持另一种场景配置。
我们有意以保守的方式设计这一机制:强烈且空间上一致的证据可以创建局部化的声源区域,而微弱、弥散或模糊的证据则保留为环境语境的一部分,而不会被强行归入某个具体物体。
EchoForge 的未来计划
主要挑战之一在于,不同类型的音效需要不同类型的表示方式。EchoForge 已经能够区分局部化声源和更为弥散的环境音。例如,风可以影响植被和环境氛围等环境元素,而不是被表示为单个对象。
未来的版本可以将这一思路扩展到更复杂的声音。人群可以被表示为密度区域或实体组,而不是单个声源;而混响则可以提供额外线索,帮助判断环境是开放还是封闭,并有可能推断其规模。
另一个重要方向是改进声音事件定位。EchoForge 目前将语义识别与相对粗略的空间线索相结合。在未来的版本中,我们希望探索 SELD 风格的方法,即联合执行声音事件定位与检测,从而更容易区分并在空间上组织多个同时出现的声音源。当同一段录音中多个声音强烈重叠时,声源分离也可能有所帮助。
我们还希望大幅扩展系统的语义与程序化词汇表。蟋蟀/黄昏这一案例凸显了一个重要局限:如果生成阶段尚不知道如何表示某种声音,那么仅仅识别出它是不够的。添加更多声音家族、资产、环境行为和生成规则,将使 EchoForge 能够解读更广泛多样的声景。
EchoForge 已经通过时间方向事件来分析随时间变化的方向性证据。更进一步的做法是利用这些方向信息的变化来推断声源本身是否在移动,然后将估计出的运动转化为生成场景中的动画实体。这将使环境能够随声音动态演化,而不是基本保持静止。
从更长远来看,我们也有兴趣减少对手动定义规则的依赖,探索更多由数据辅助的音频证据与视觉场景元素之间的映射,并朝着更快速乃至最终实时的场景生成迈进。
音频场景生成的价值
目前,我们认为其最大的潜力在于创意与辅助工具,而非精确重建。
对于游戏开发者和环境美术师来说,一段实地录音可以成为程序化世界构建的快速起点。声音设计师只需提供一段环境音录音,就能立即获得对该声景的粗略、可探索的可视化呈现。
对于从事空间音频或 XR 的技术美术师来说,它也同样有用,可以让他们将声音被检测到的位置以及系统如何解读音频环境可视化。
另一个我们觉得特别有趣的方向是无障碍。对于失聪或听障用户,基于 EchoForge 衍生的系统有望将声景中的元素转化为视觉和空间信息。它不只是指示有声音发生,还能传达检测到的是哪种声音、大致来自何处,以及它代表的是一个局部声源还是更为弥散的环境事件。在沉浸式环境中,这可以提供一种感知空间音频信息的替代方式。
EchoForge 还可以应用于教育、声景可视化,或探索那些难以直接进入的环境的录音。
不过,对于真实环境的重建,我们会谨慎得多。EchoForge 并非旨在成为取证或度量级重建系统。它的优势在于让解读过程变得可见:音频暗示了什么、哪些地方证据充分,以及系统在何处做出了不确定的程序化选择。
Anamaria Buliga 和 Kamil Tebani,ESGI 计算机图形学硕士生
相关链接
原文链接:https://80.lv/articles/echoforge-uses-spatial-sound-to-build-3d-worlds-in-unity


喜欢这篇内容吗?