
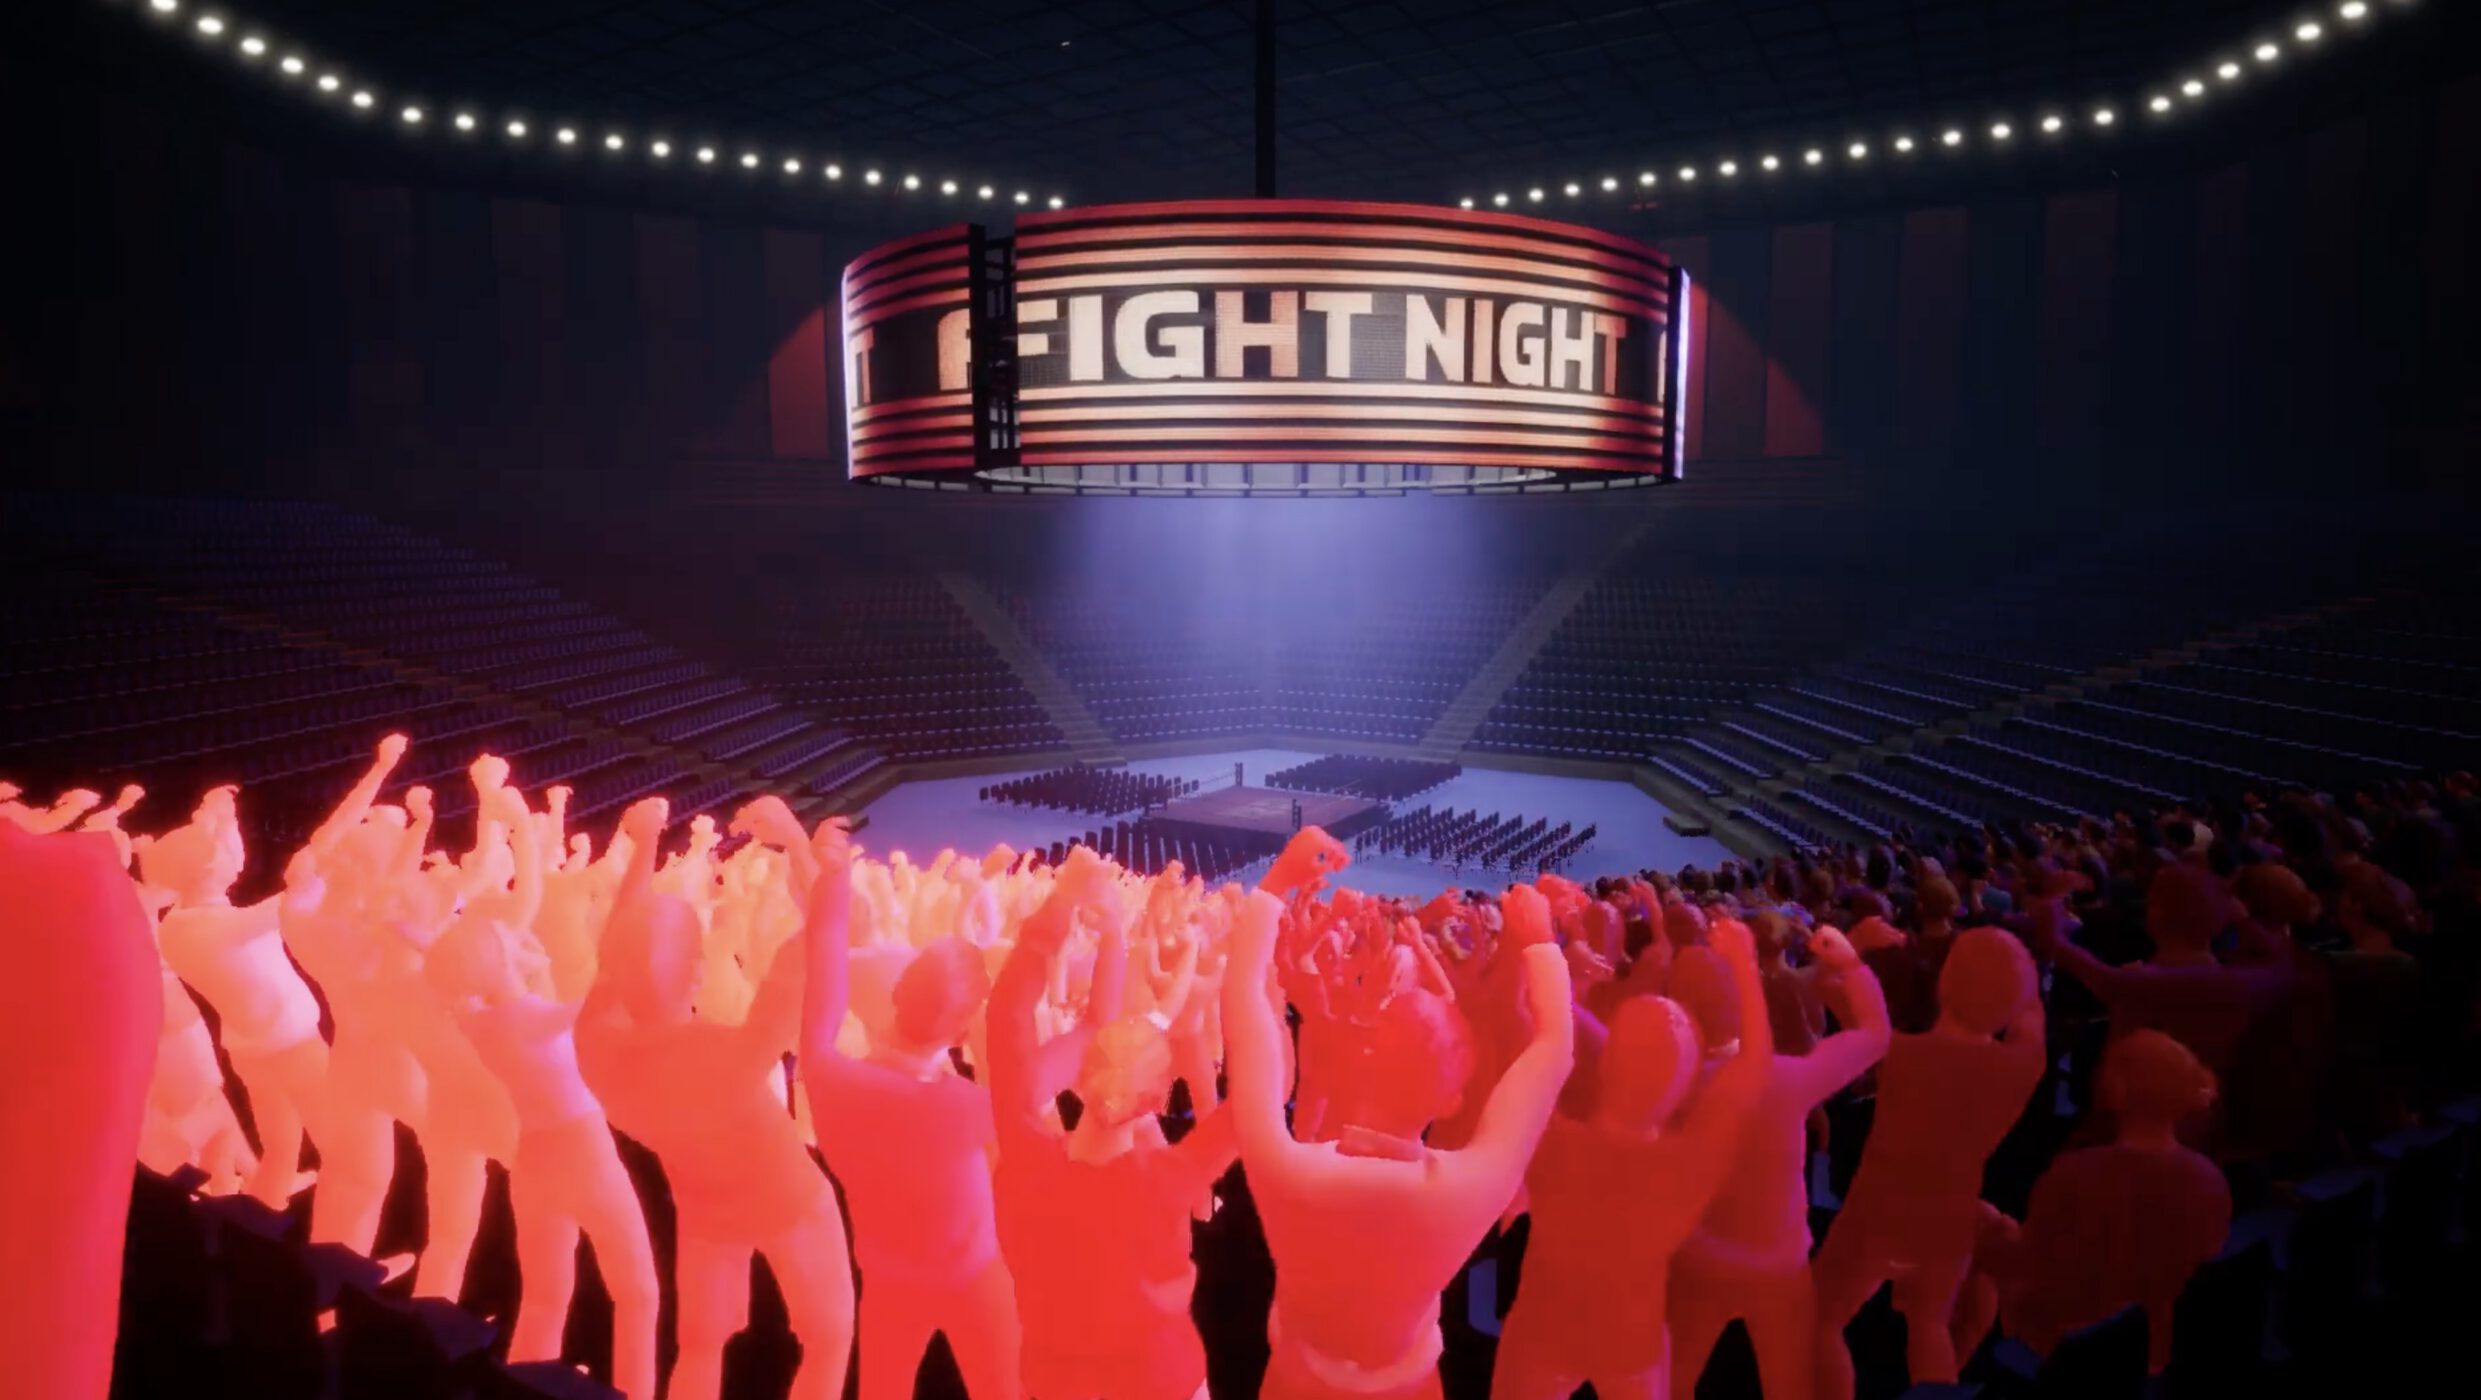
GPU驱动人群系统:如何在单一线程中实现6000个智能体
引言
大家好,我是 Kaley Cho,一名致力于探索实时环境技术边界的技术美术。我始终着迷于在极致视觉密度与高性能之间取得平衡的挑战,这个项目的初衷就是想看看能否在不加重 CPU 负担的前提下,创建一个规模庞大、反应灵敏、栩栩如生的人群系统。这是一个回报丰厚的解谜过程,它将程序化 Houdini 设置与优化后的虚幻引擎着色器衔接了起来。
要为容纳超过 6,000 名观众的大型拳击场填充观众,通常会直接压垮 CPU 密集型的骨骼网格体系统。通过使用顶点动画纹理 (VAT)将角色变形计算卸载到 GPU,我得以在保持高保真运动的同时维持高帧率。以下解析将展示从程序化 Houdini 设置到基于着色器的动画触发的完整管线,聚焦于现代游戏开发的核心技术美术原理。
本文将带领您走完从原始体育场几何体到鲜活人群的完整流程。
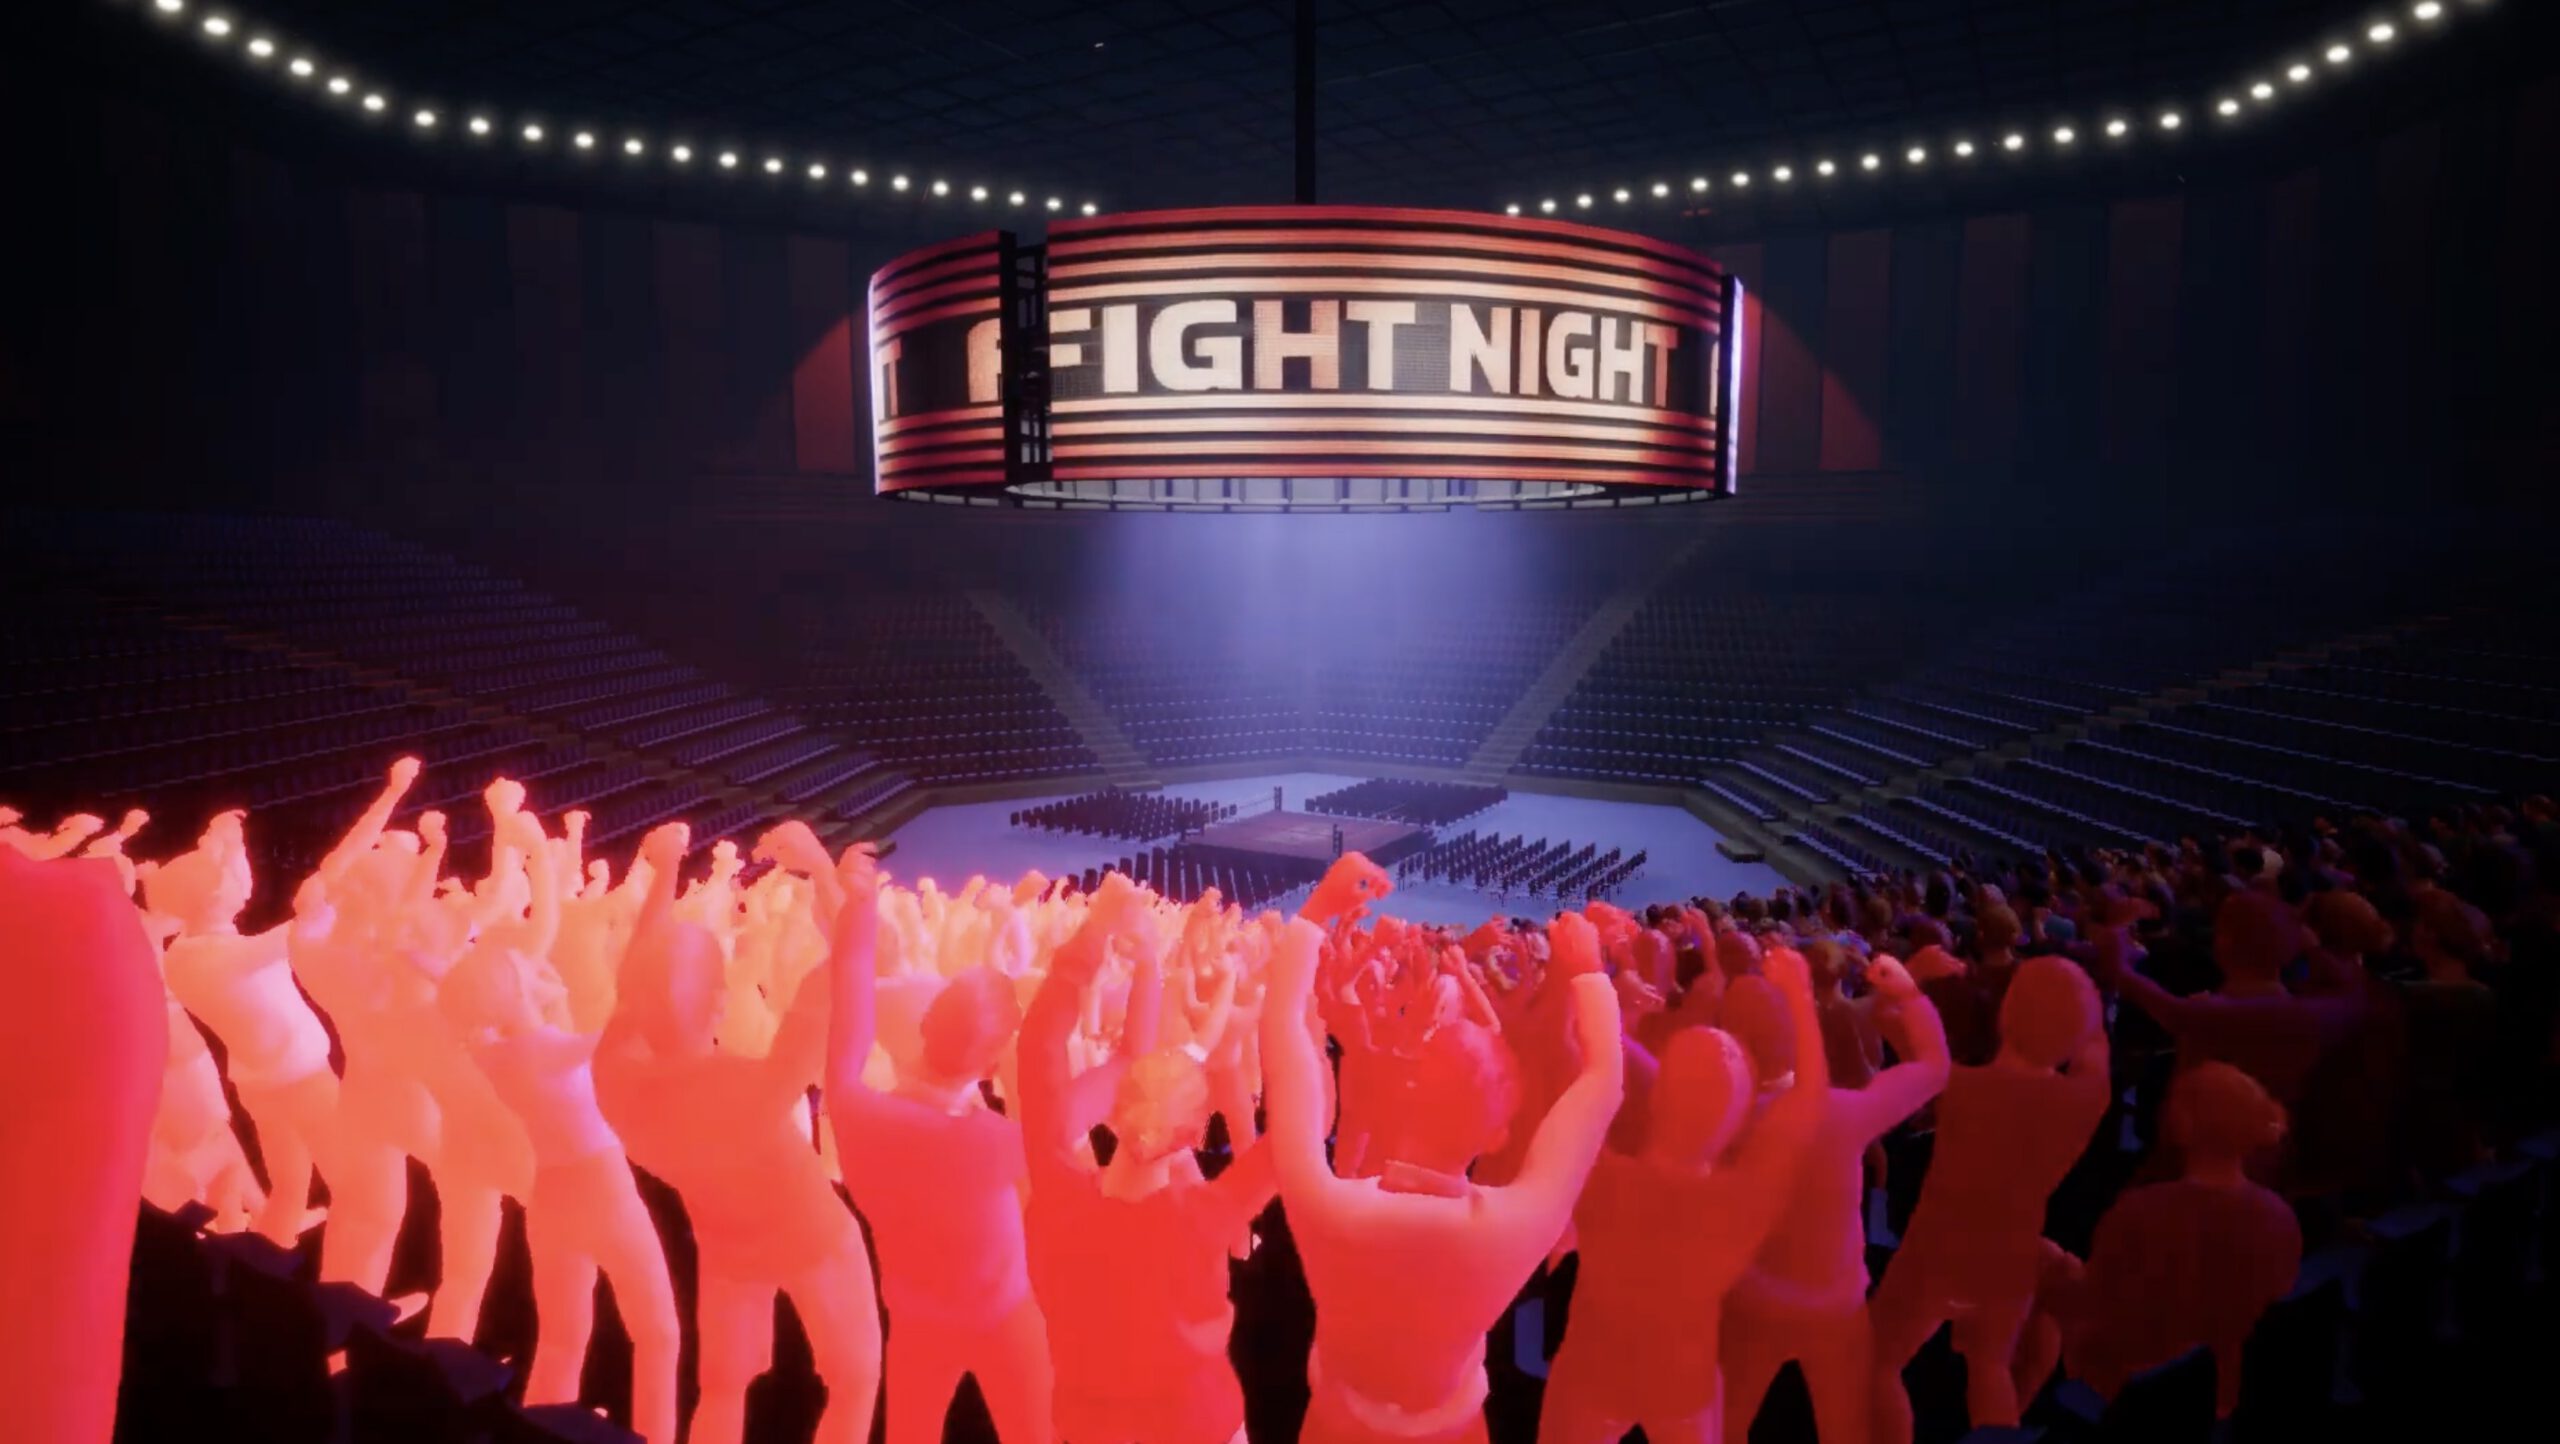
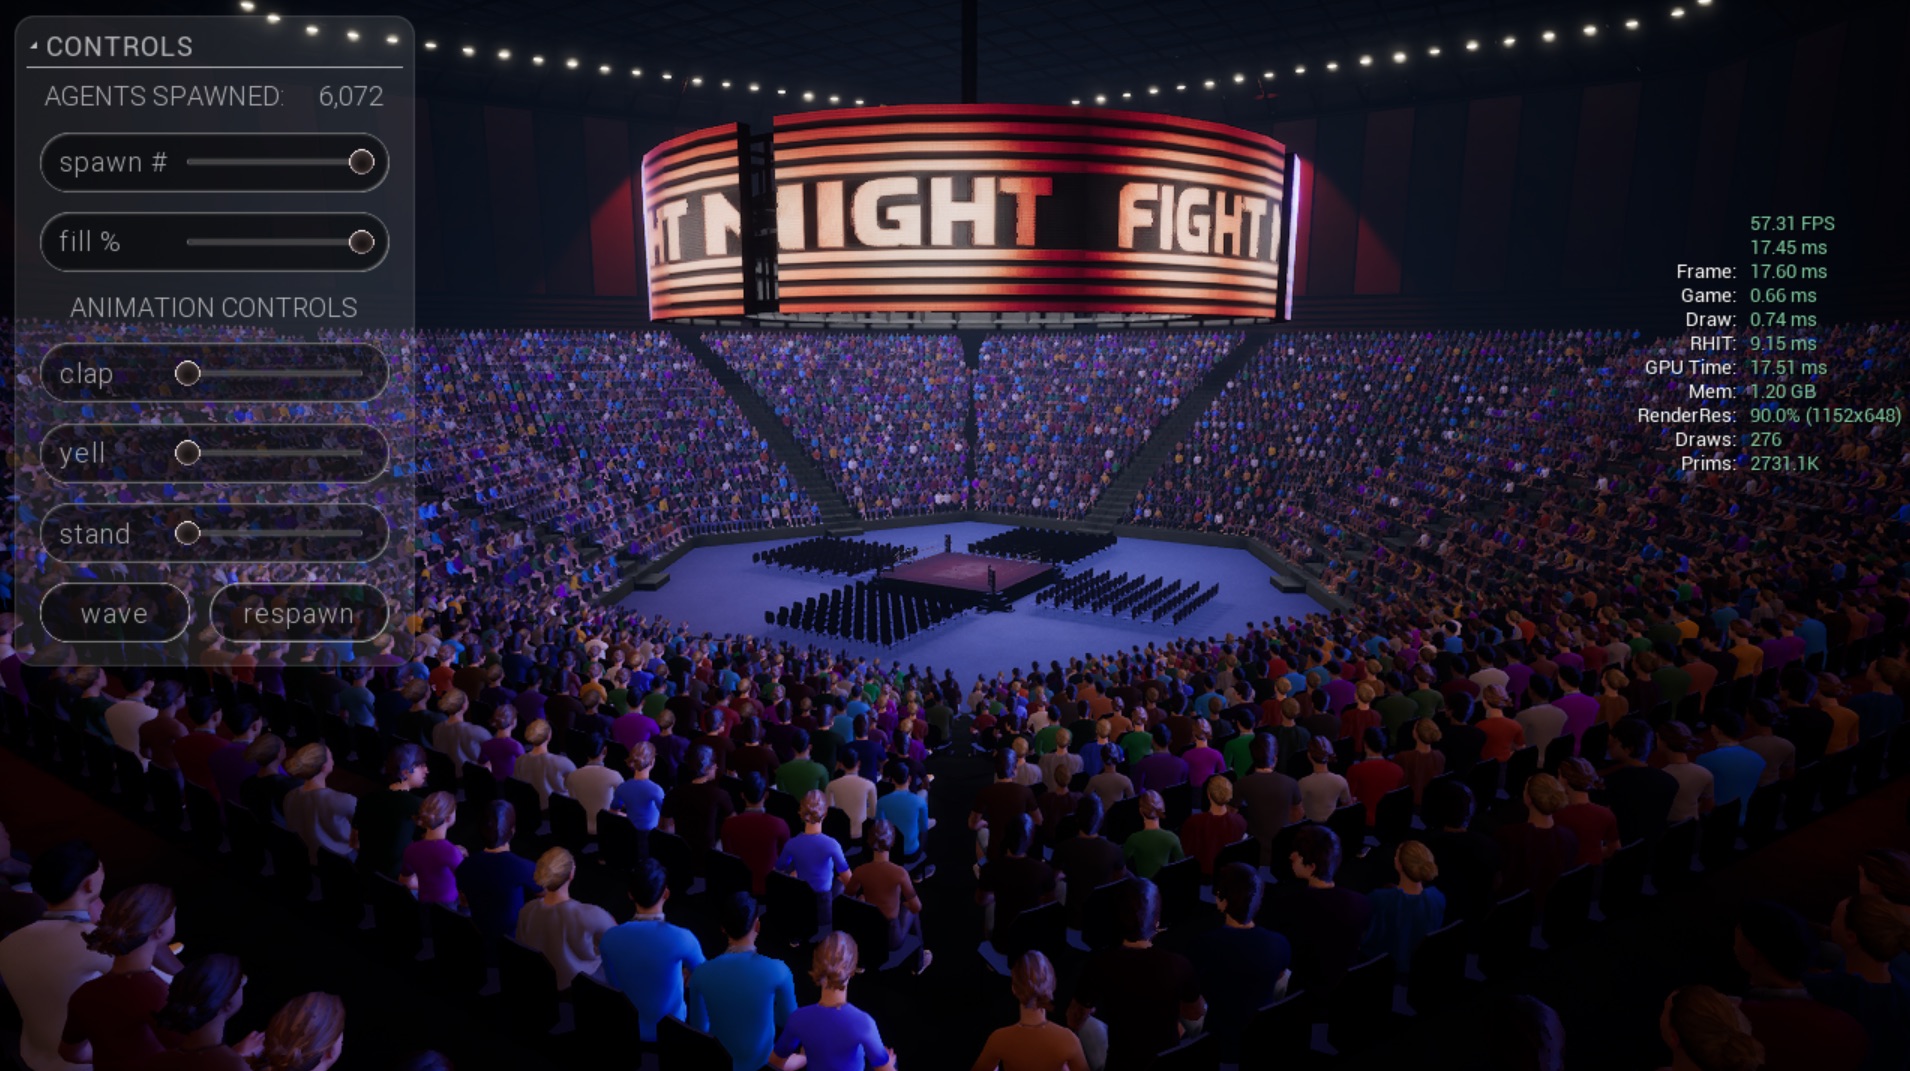
完成后的系统:6,072 名观众实时动画,通过实时 UI 控制。GPU 时间:17.51 ms。绘制调用:276。
第一部分:在 Houdini 中构建基础
第一步:提取座位位置
第一个问题说起来简单但手动解决却很烦人:每位观众坐在哪里,面朝哪个方向?手动放置 6,000 个变换是不可能的,因此改用体育场自身的座位几何体来完成这项工作。
将体育场的 FBX 导入 Houdini,隔离椅子几何体,然后使用 For Each循环遍历每个相连的部分。在循环内部,一个 VEX wrangle 使用 getbbox()找到每个座位的包围盒,并利用 addpoint()在其中心处生成一个点。最终得到一个干净的点云,没有任何多余几何体。
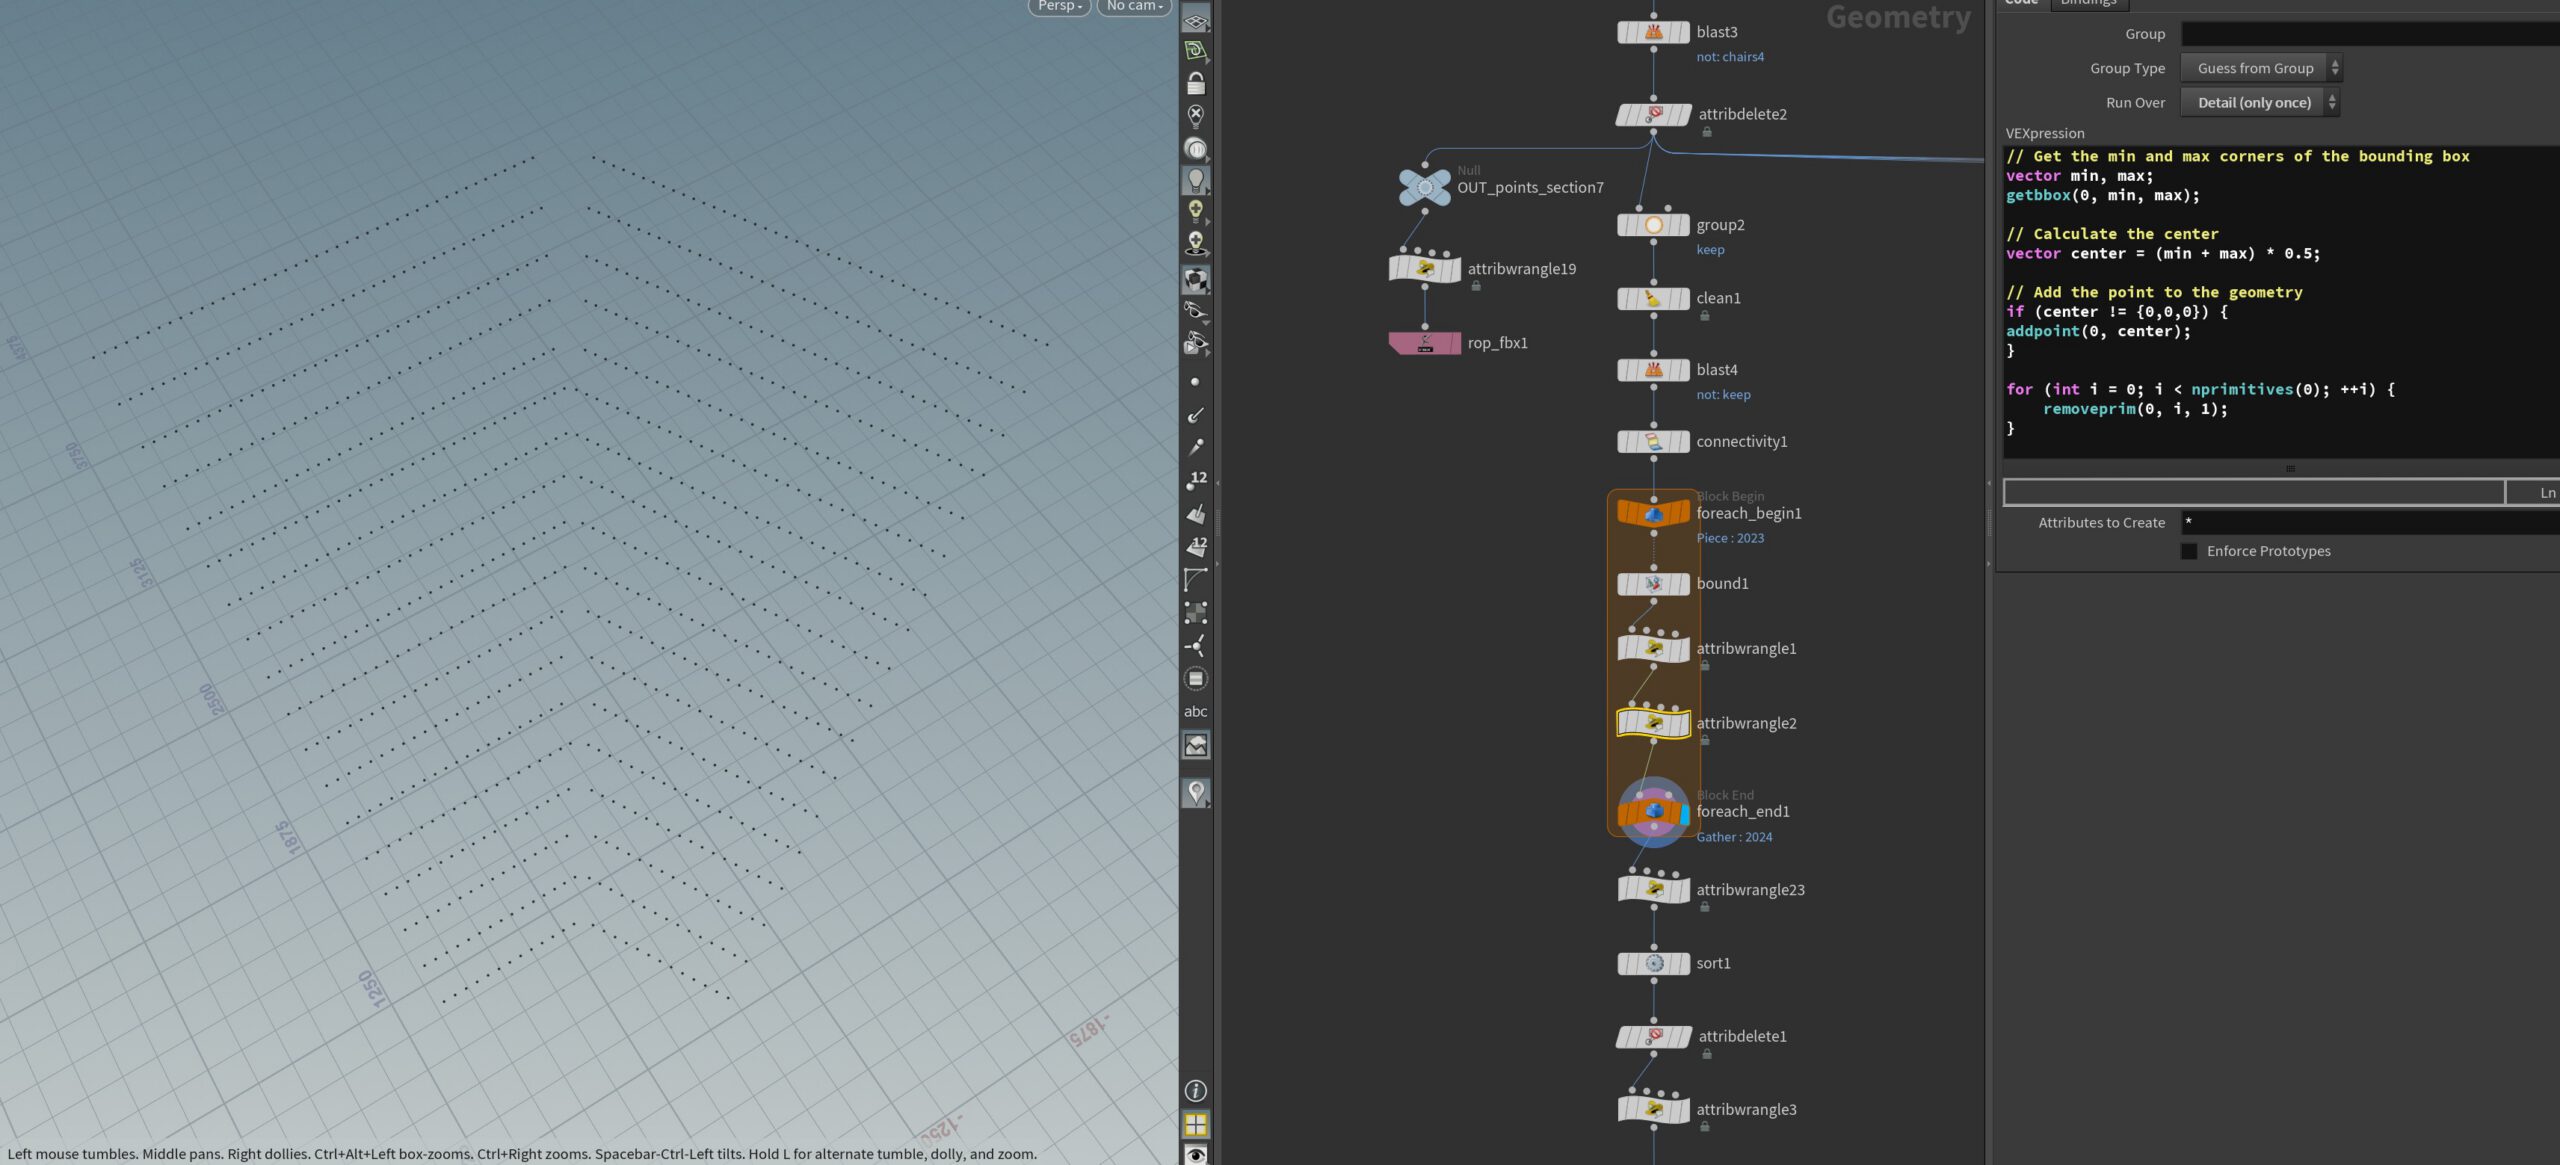
虚幻引擎使用Z 轴向上坐标系,而 Houdini 默认Y 轴向上。为确保 VAT 位置与引擎内的静态网格体实例对齐,需交换 Y 和 Z 属性并对新的 Y 取反。
// Houdini Z -> 虚幻引擎 前/后
// Houdini X -> 虚幻引擎 左/右
// Houdini Y -> 虚幻引擎 上/下
@P = set(@P.z, -@P.x, @P.y);
// 对法线应用相同的重映射
@N = set(@N.z, -@N.x, @N.y);
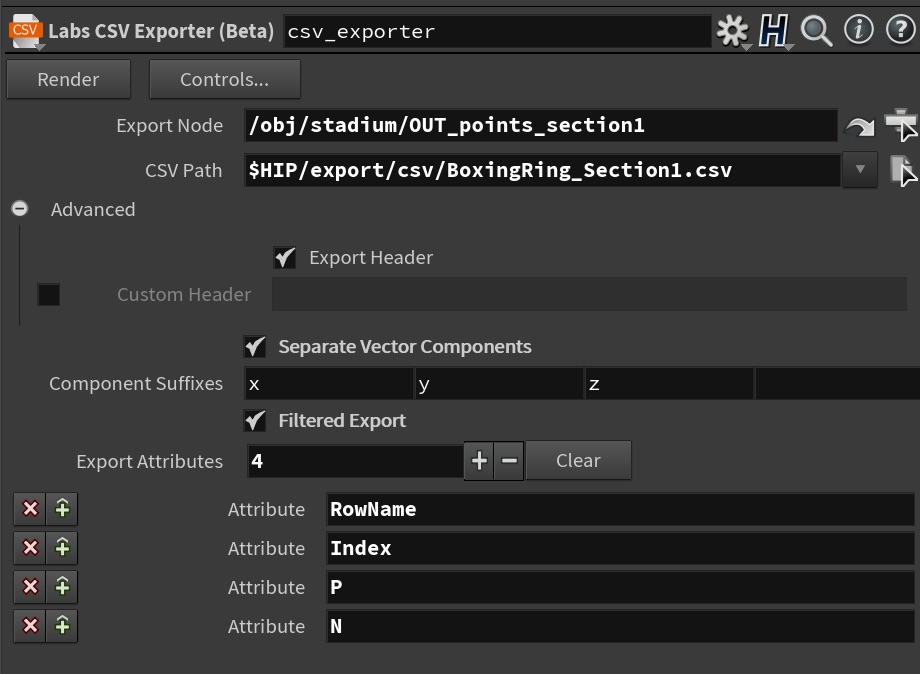
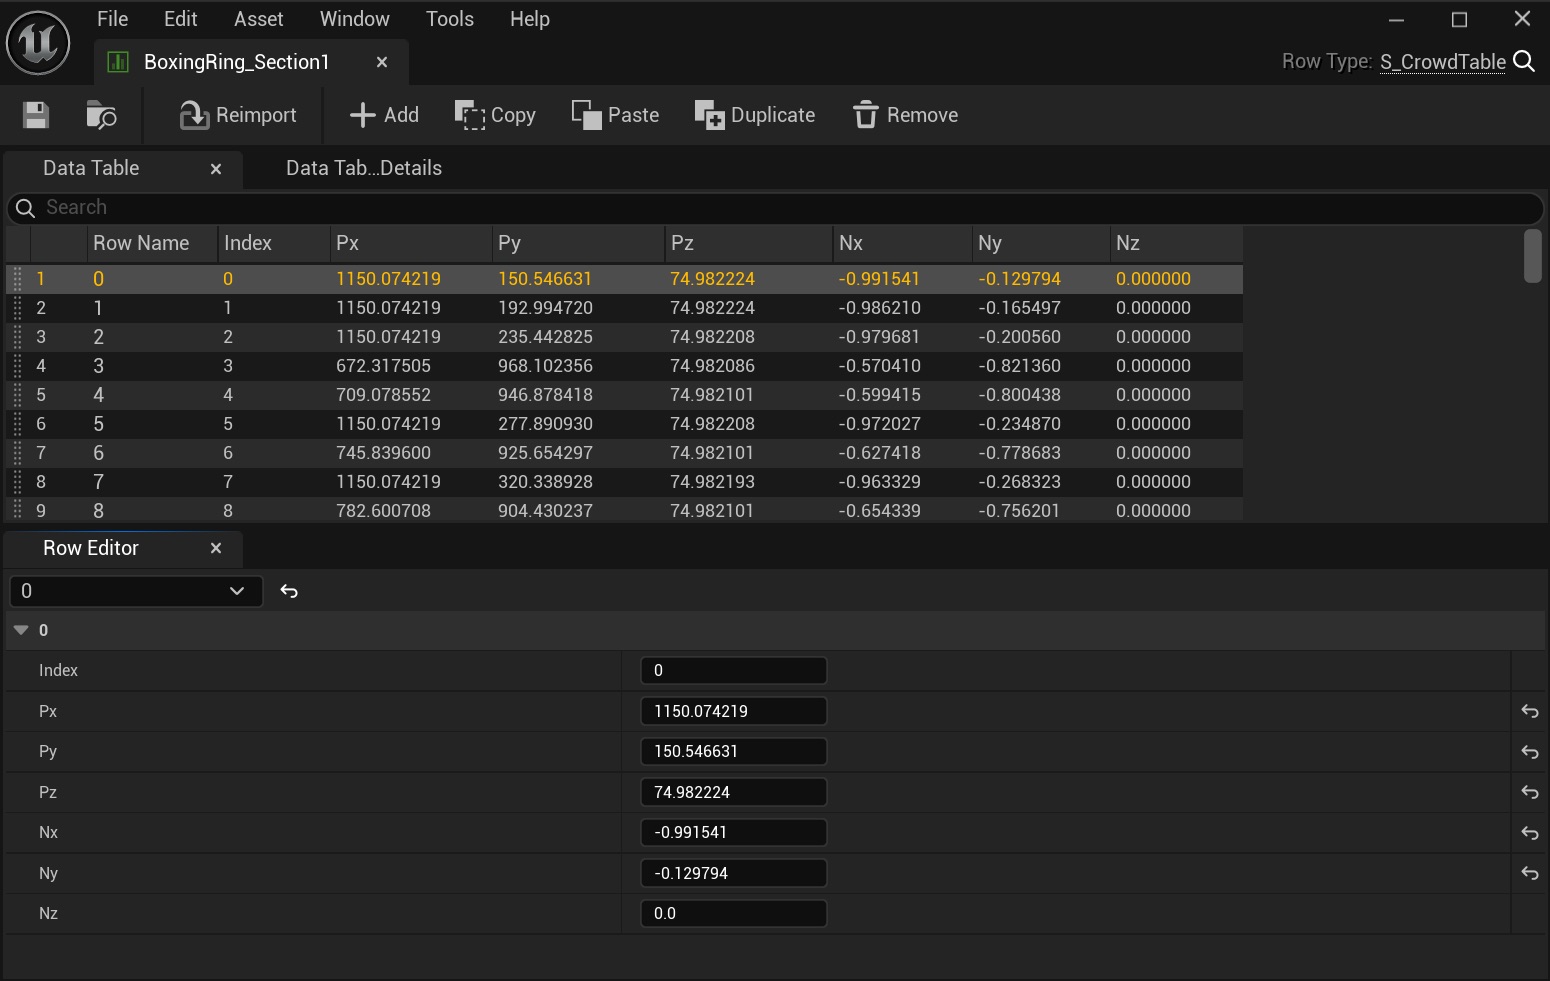
链条中的最后一个节点是Labs CSV Exporter。只导出虚幻引擎所需的四个属性:RowName、Index、P (位置,拆分为 Px/Py/Pz) 和N (法线,拆分为 Nx/Ny/Nz)。最终得到一个轻量级的电子表格,成为所有 6,000 多个座位变换的唯一数据源。
在 Unreal 中,这个 CSV 通过一个自定义结构 S_CrowdTable 作为 数据表 导入。结果是场馆内每个座位的完美组织表格。
Part 2: 在 Houdini 中烘焙 VAT
角色流程
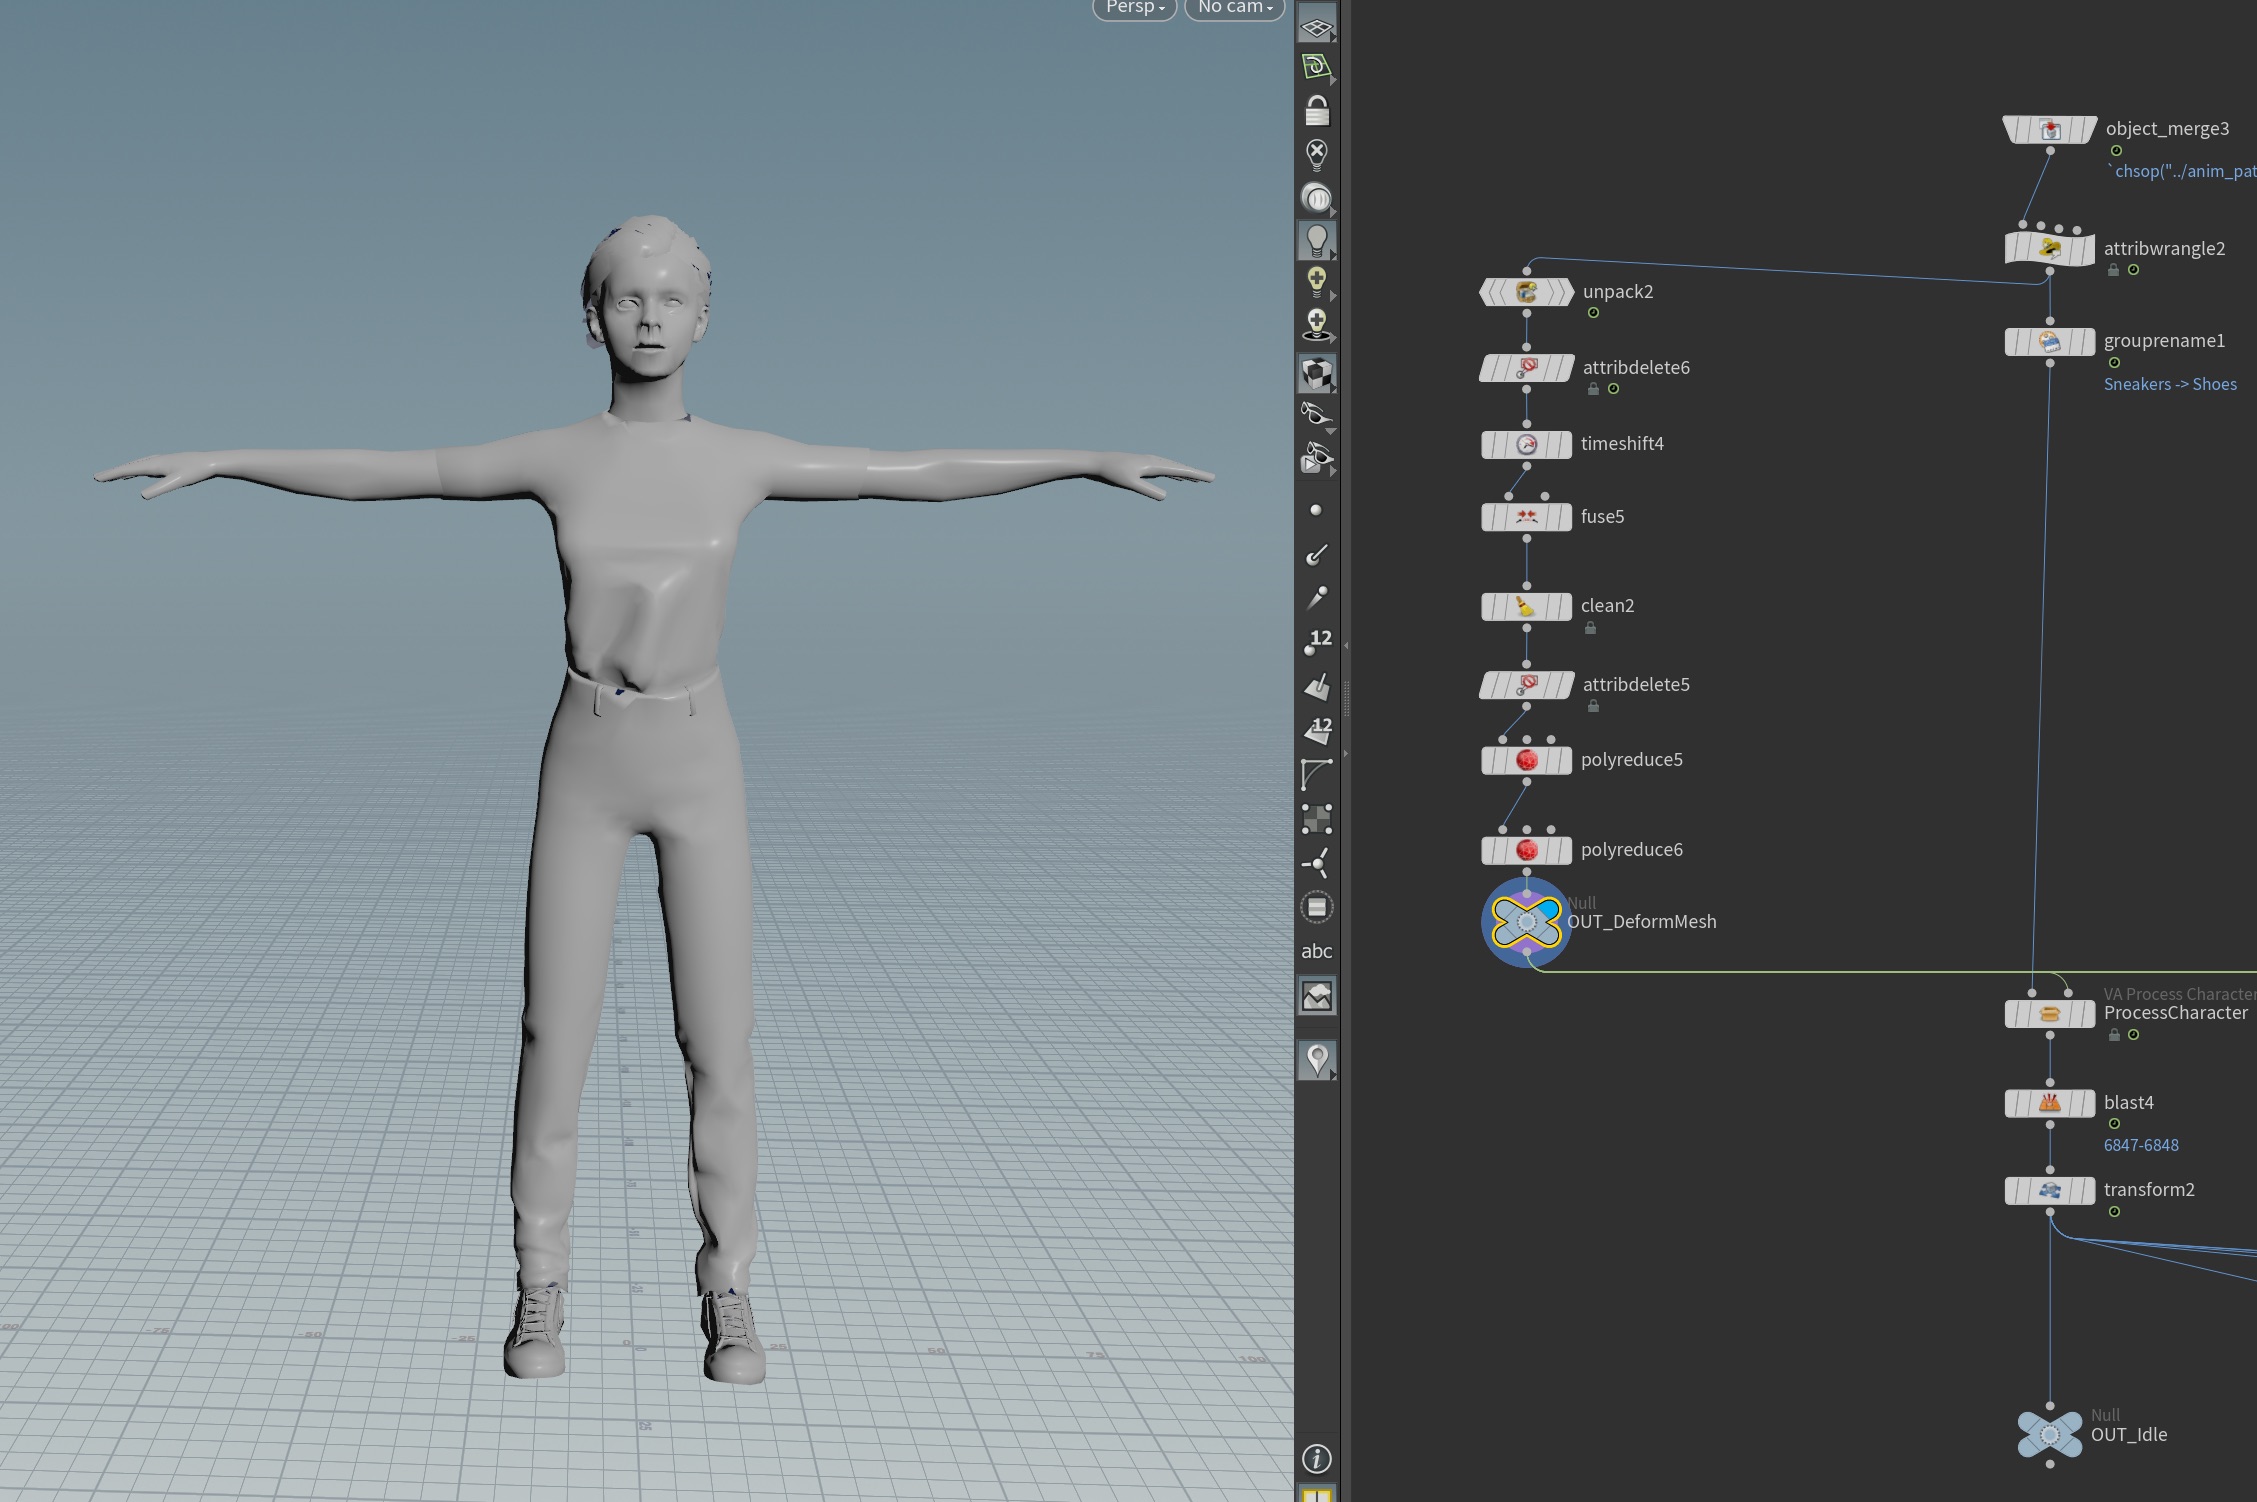
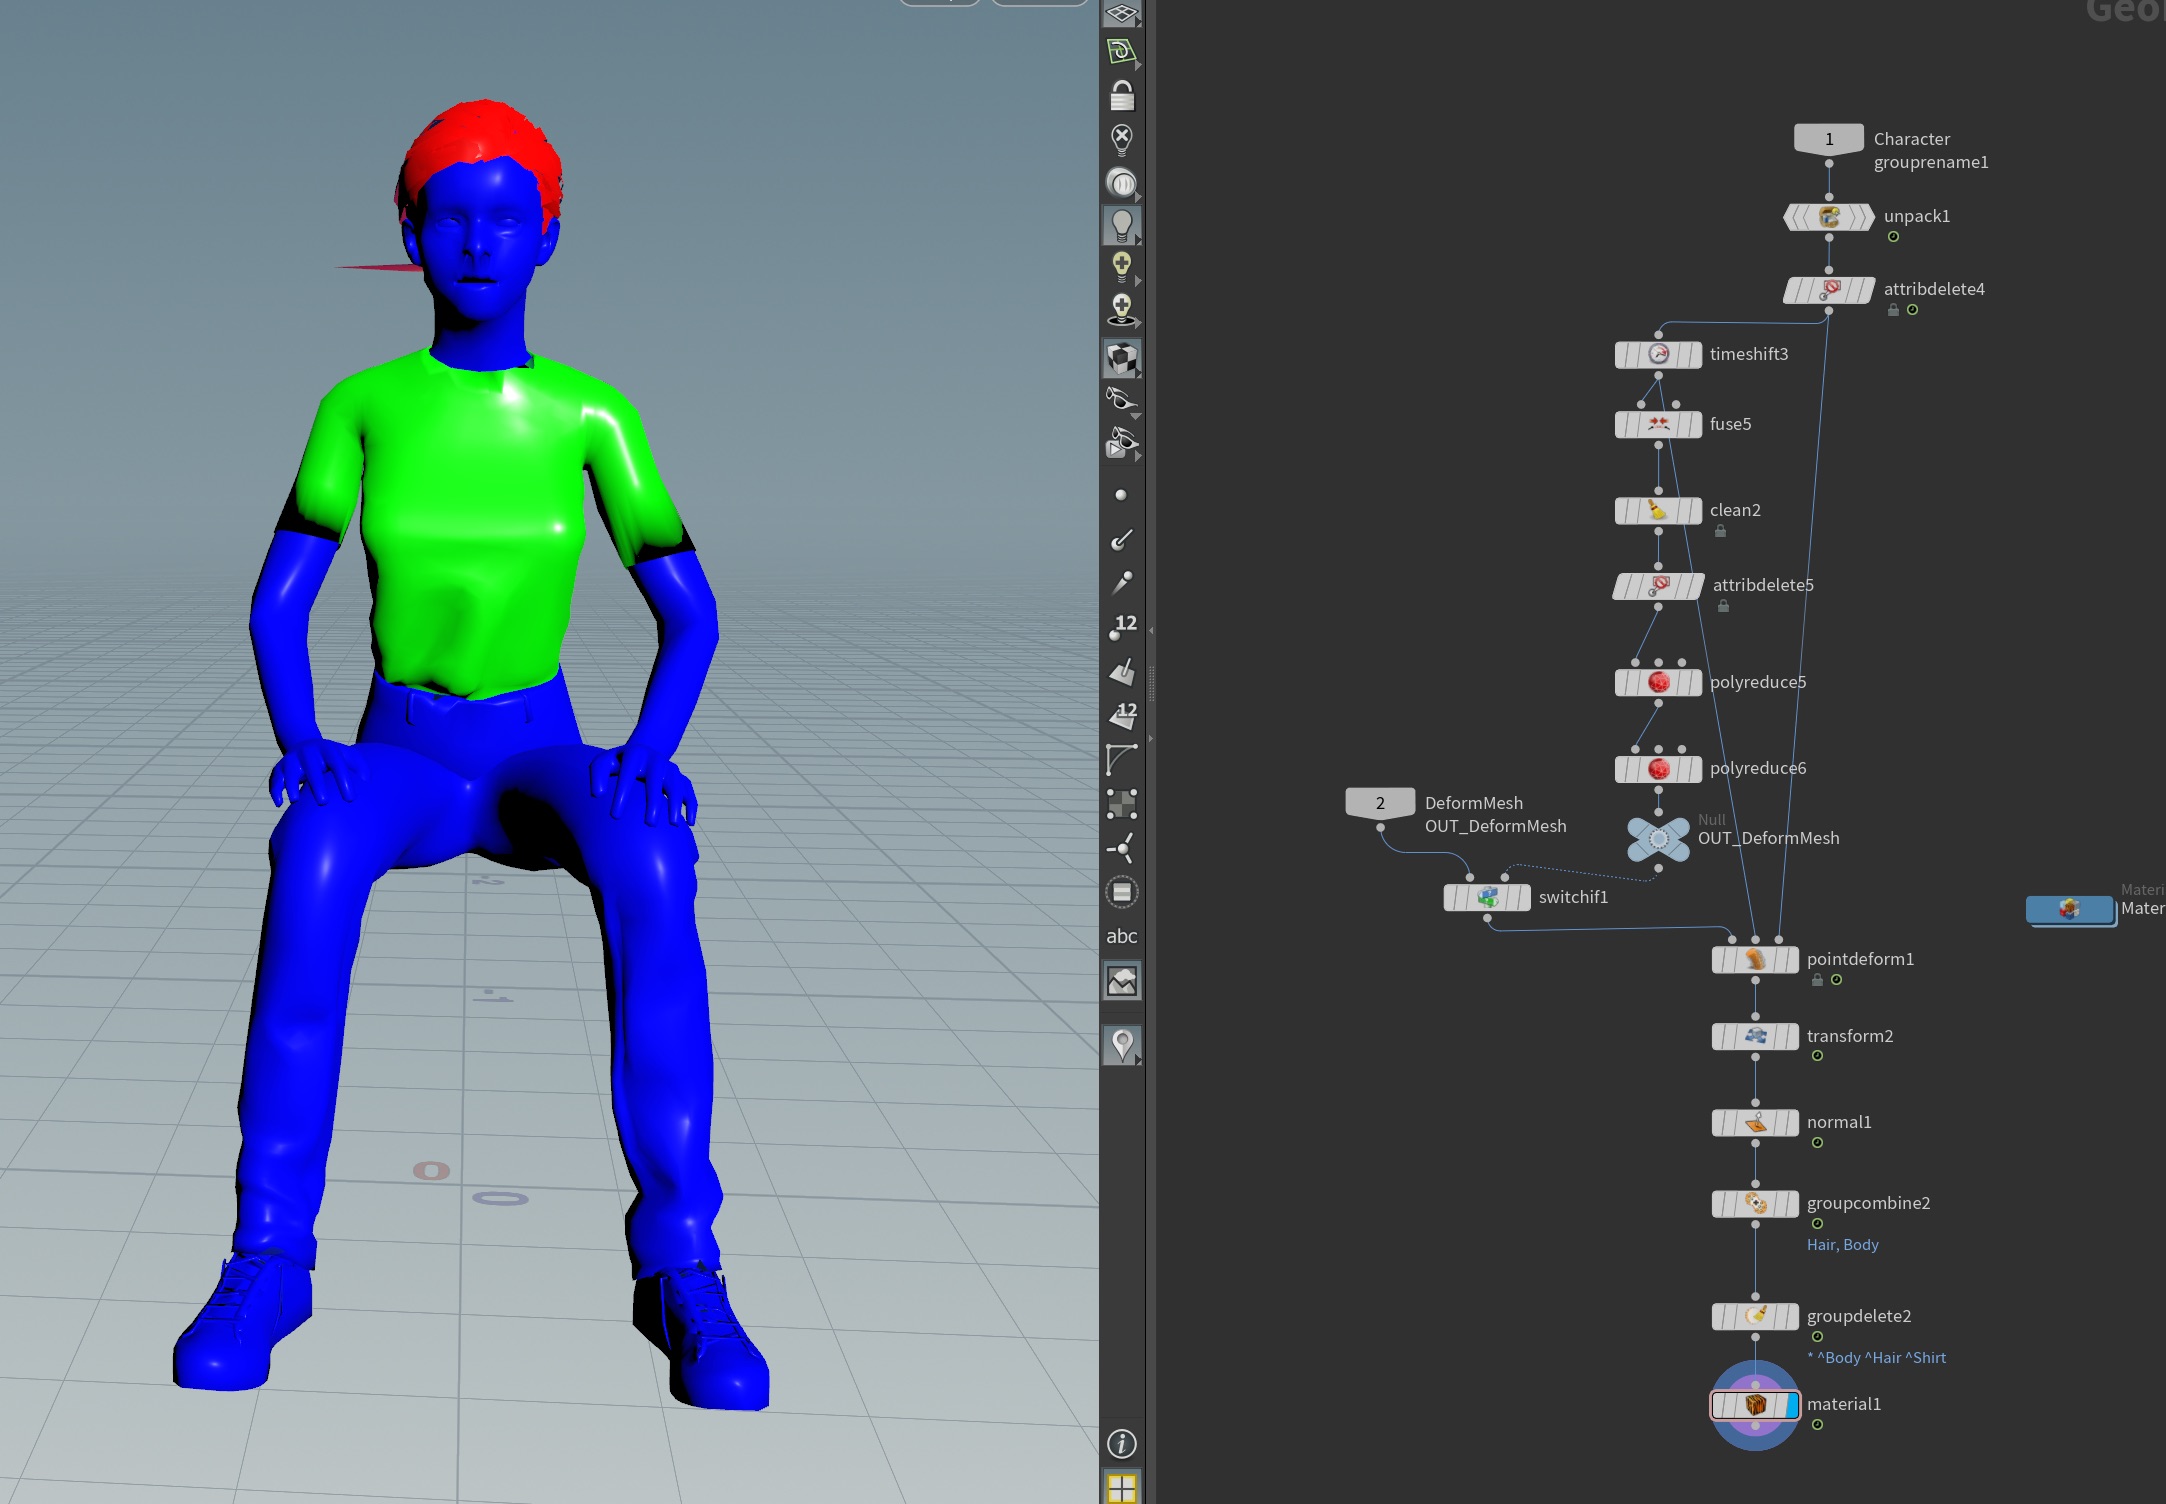
每位观众角色首先经过一个准备环节。清理网格,按合适的 LOD 减面以适应看台距离,然后分配材质组(身体、衬衫、头发),以便 Unreal 材质可以对每组应用随机颜色。
烘焙多个动画状态
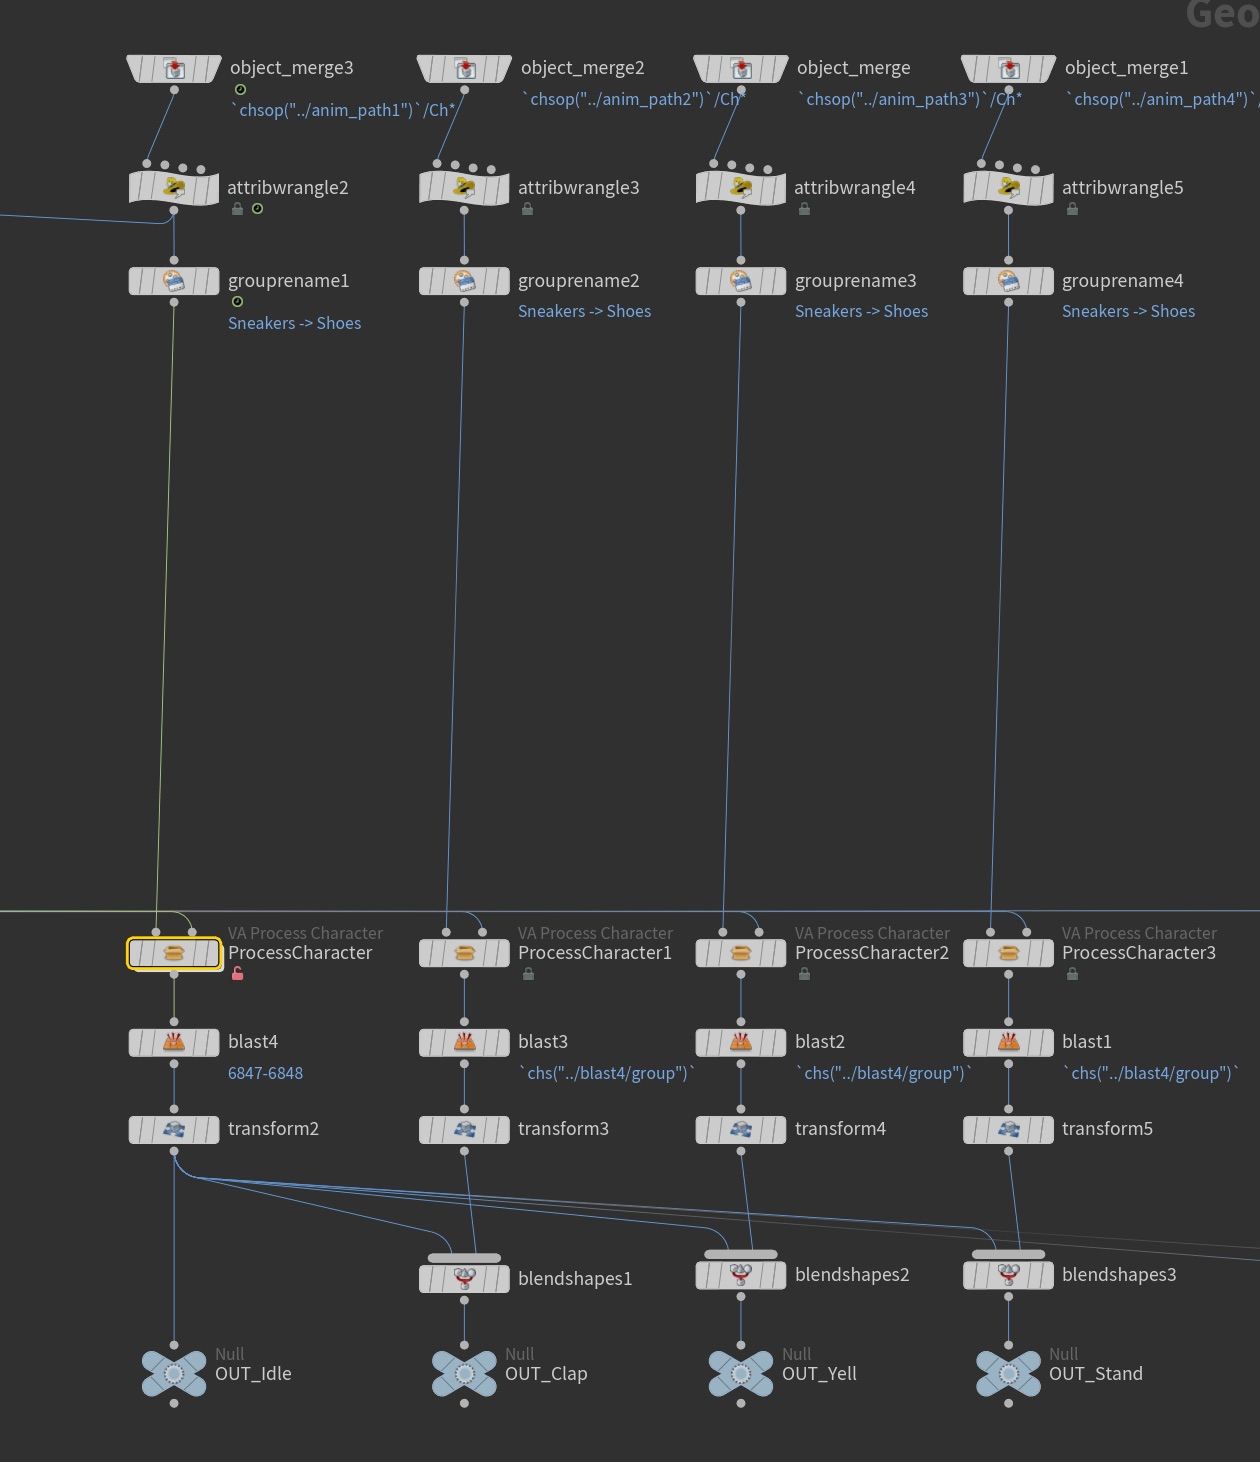
人群需要不止一个动画。需要:空闲(坐姿,细微动作)、鼓掌、喊叫 和 站立。每个动画都是独立的 VAT 烘焙。
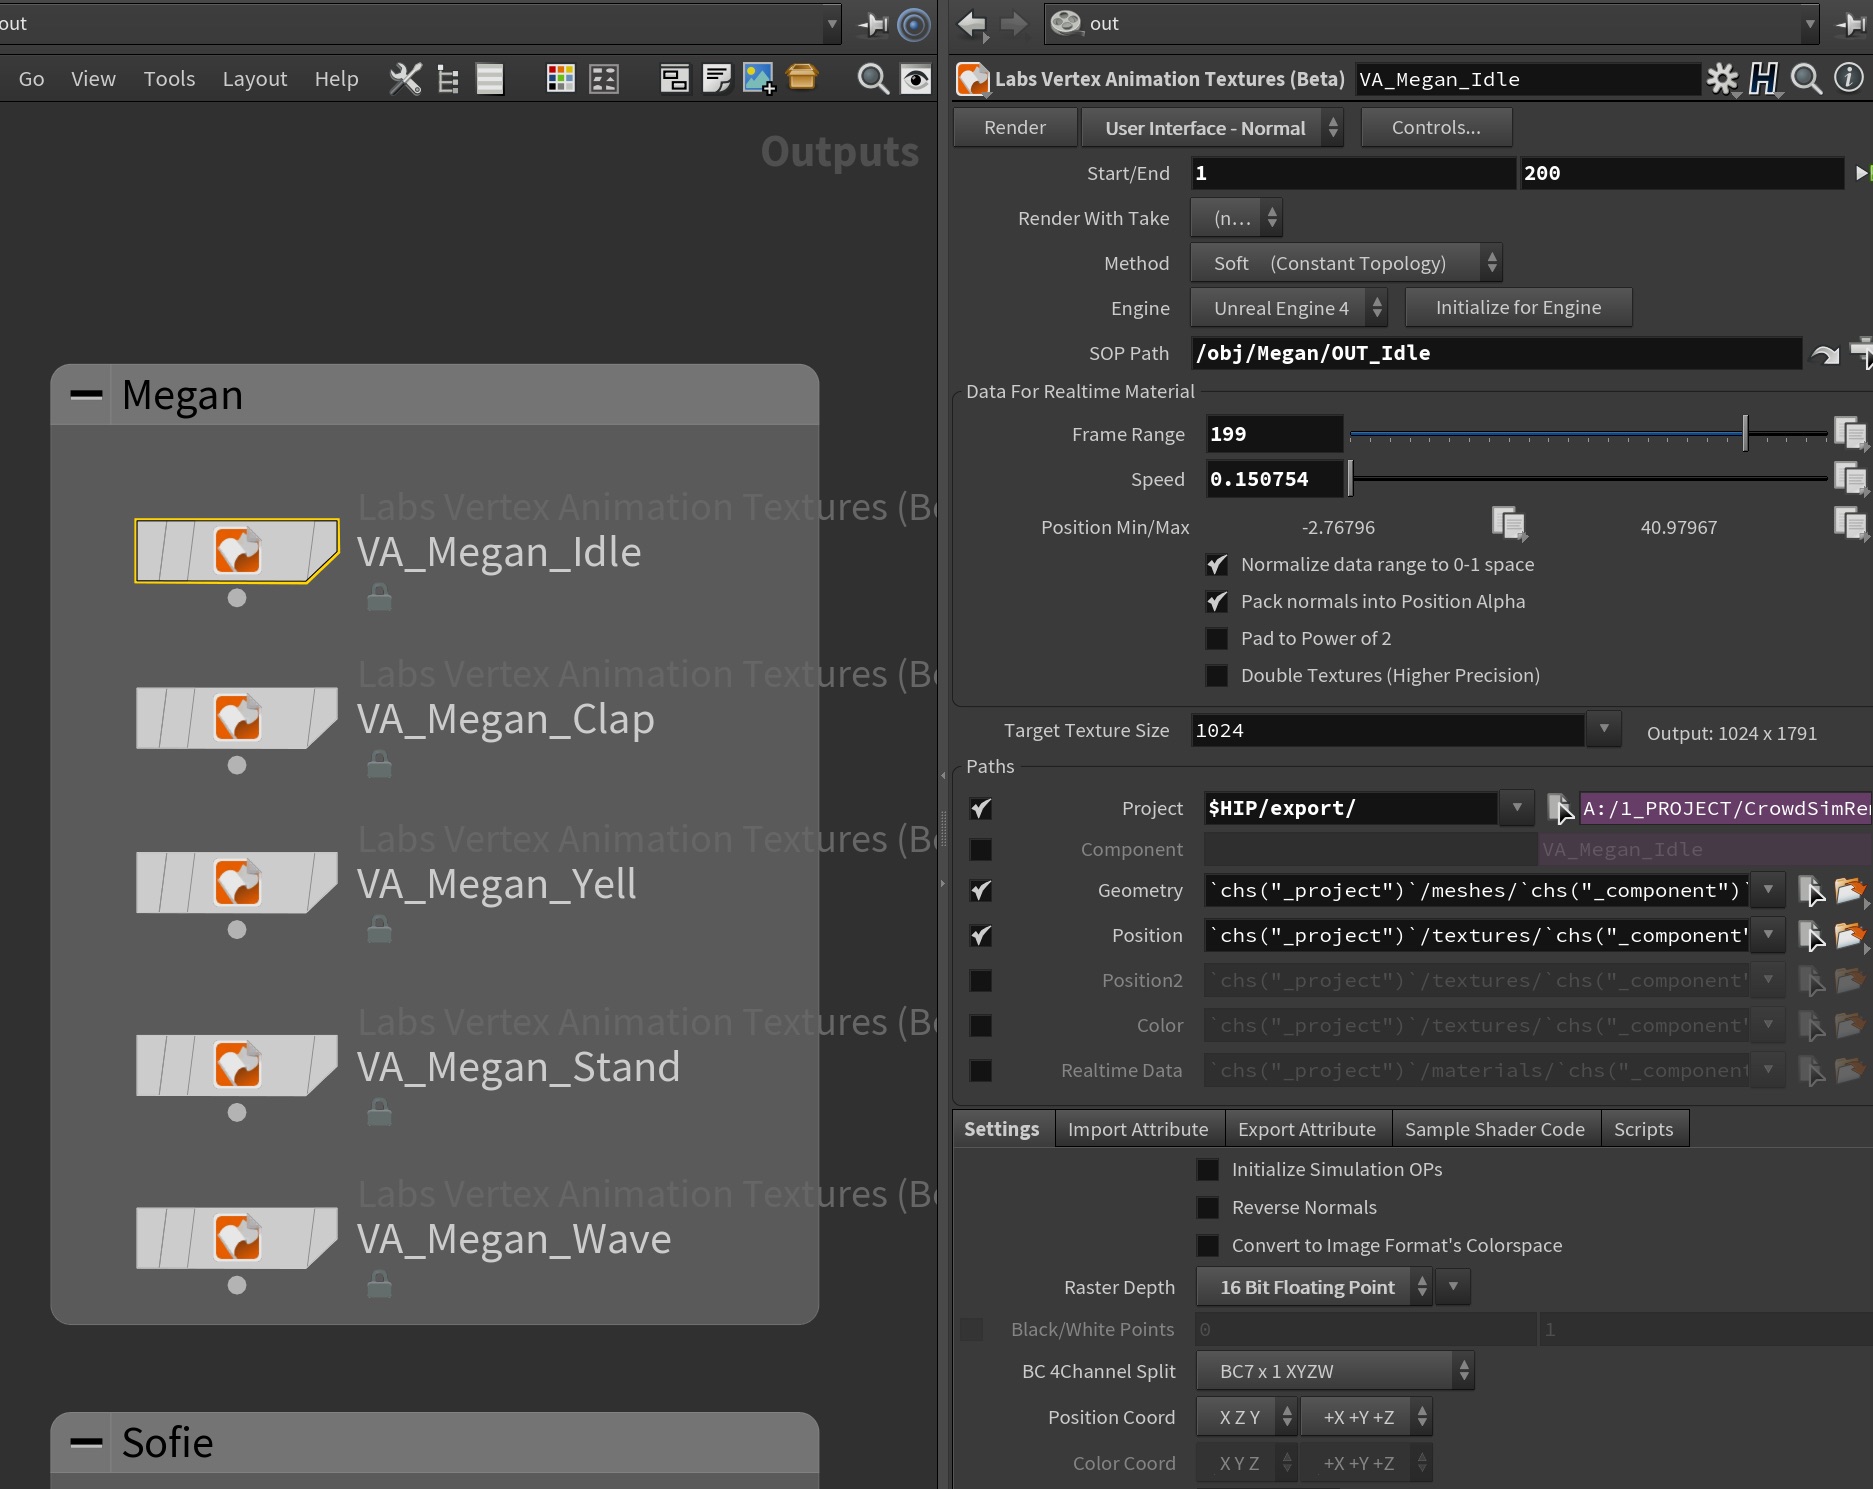
网络使用一个共享的 OUT_DeformMesh,它输入到四个并行的 ProcessCharacter 节点,每个对应一个动画状态。每个分支将网格在动画帧上变形,并输出到各自的 OUT_ 空节点,然后由 Labs VAT ROP 读取。
VAT ROP 设置
Labs 顶点动画纹理 ROP 处理实际导出。以下几个设置至关重要:
- 方法:Soft(恒定拓扑) — 网格拓扑在帧之间从不改变,这是 VAT 正确工作的前提。
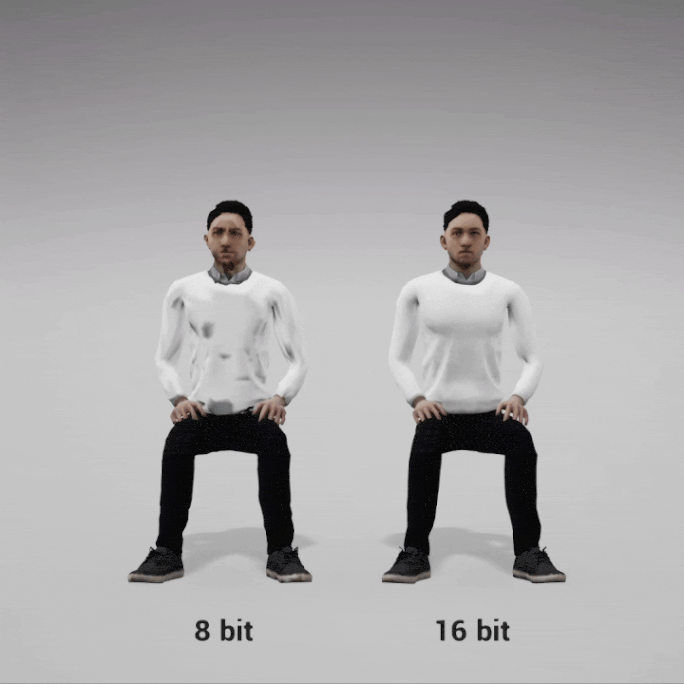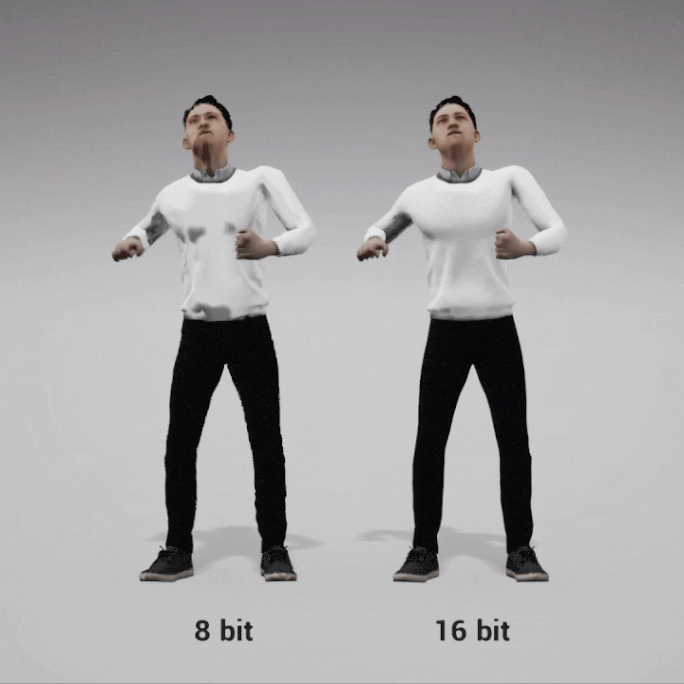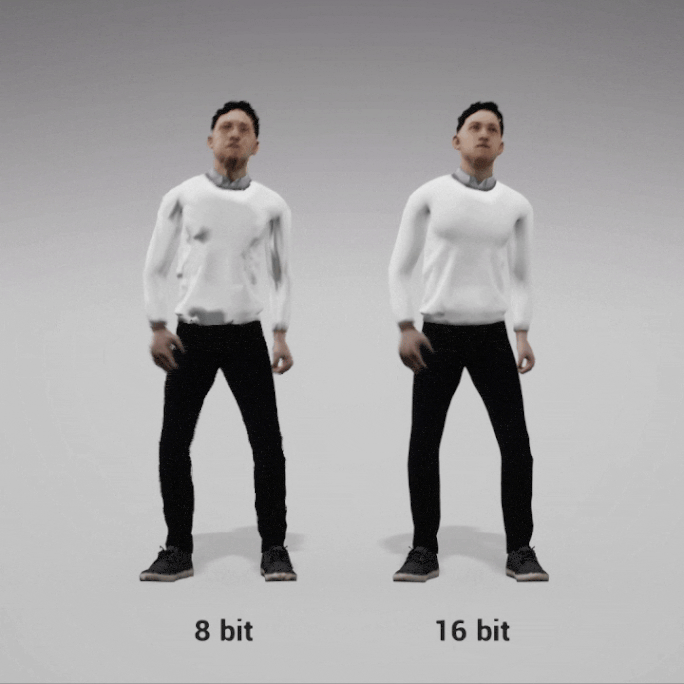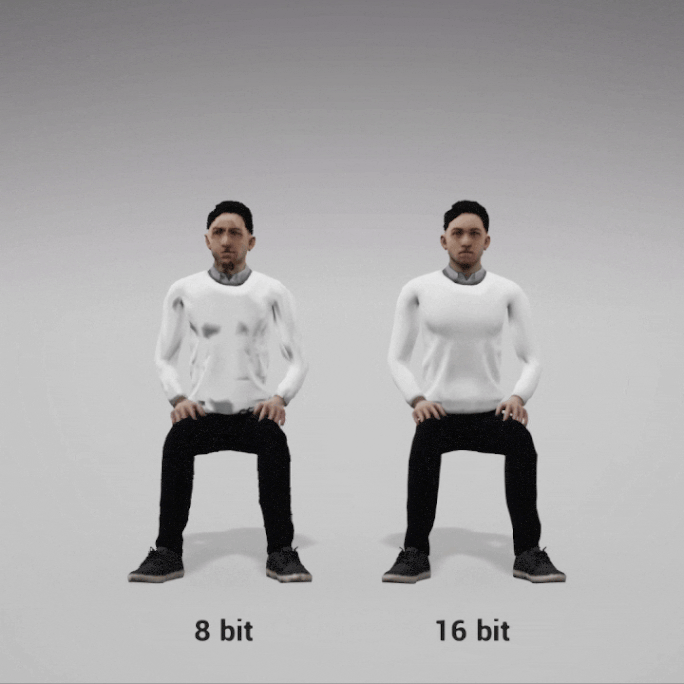
- 光栅深度:16 位浮点 — 这是必须的。8 位纹理精度不足以存储世界空间位置偏移,会导致可见的顶点抖动,尤其是当摄像机靠近看台时。
- 将法线打包到位置 Alpha — 将法线数据打包到位置纹理的 Alpha 通道中,节省一个纹理槽位。
- 引擎:Unreal Engine — 为 UE 设置正确的输出坐标约定。
Part 3: Unreal Engine 着色器
材质(M_VAT_HISM)是 GPU 进行所有计算的地方。它读取 VAT 纹理,随时间滚动,在动画状态之间混合,随机化颜色,并处理波浪效果,所有这一切在运行时无需每个实例的任何 CPU 指令。
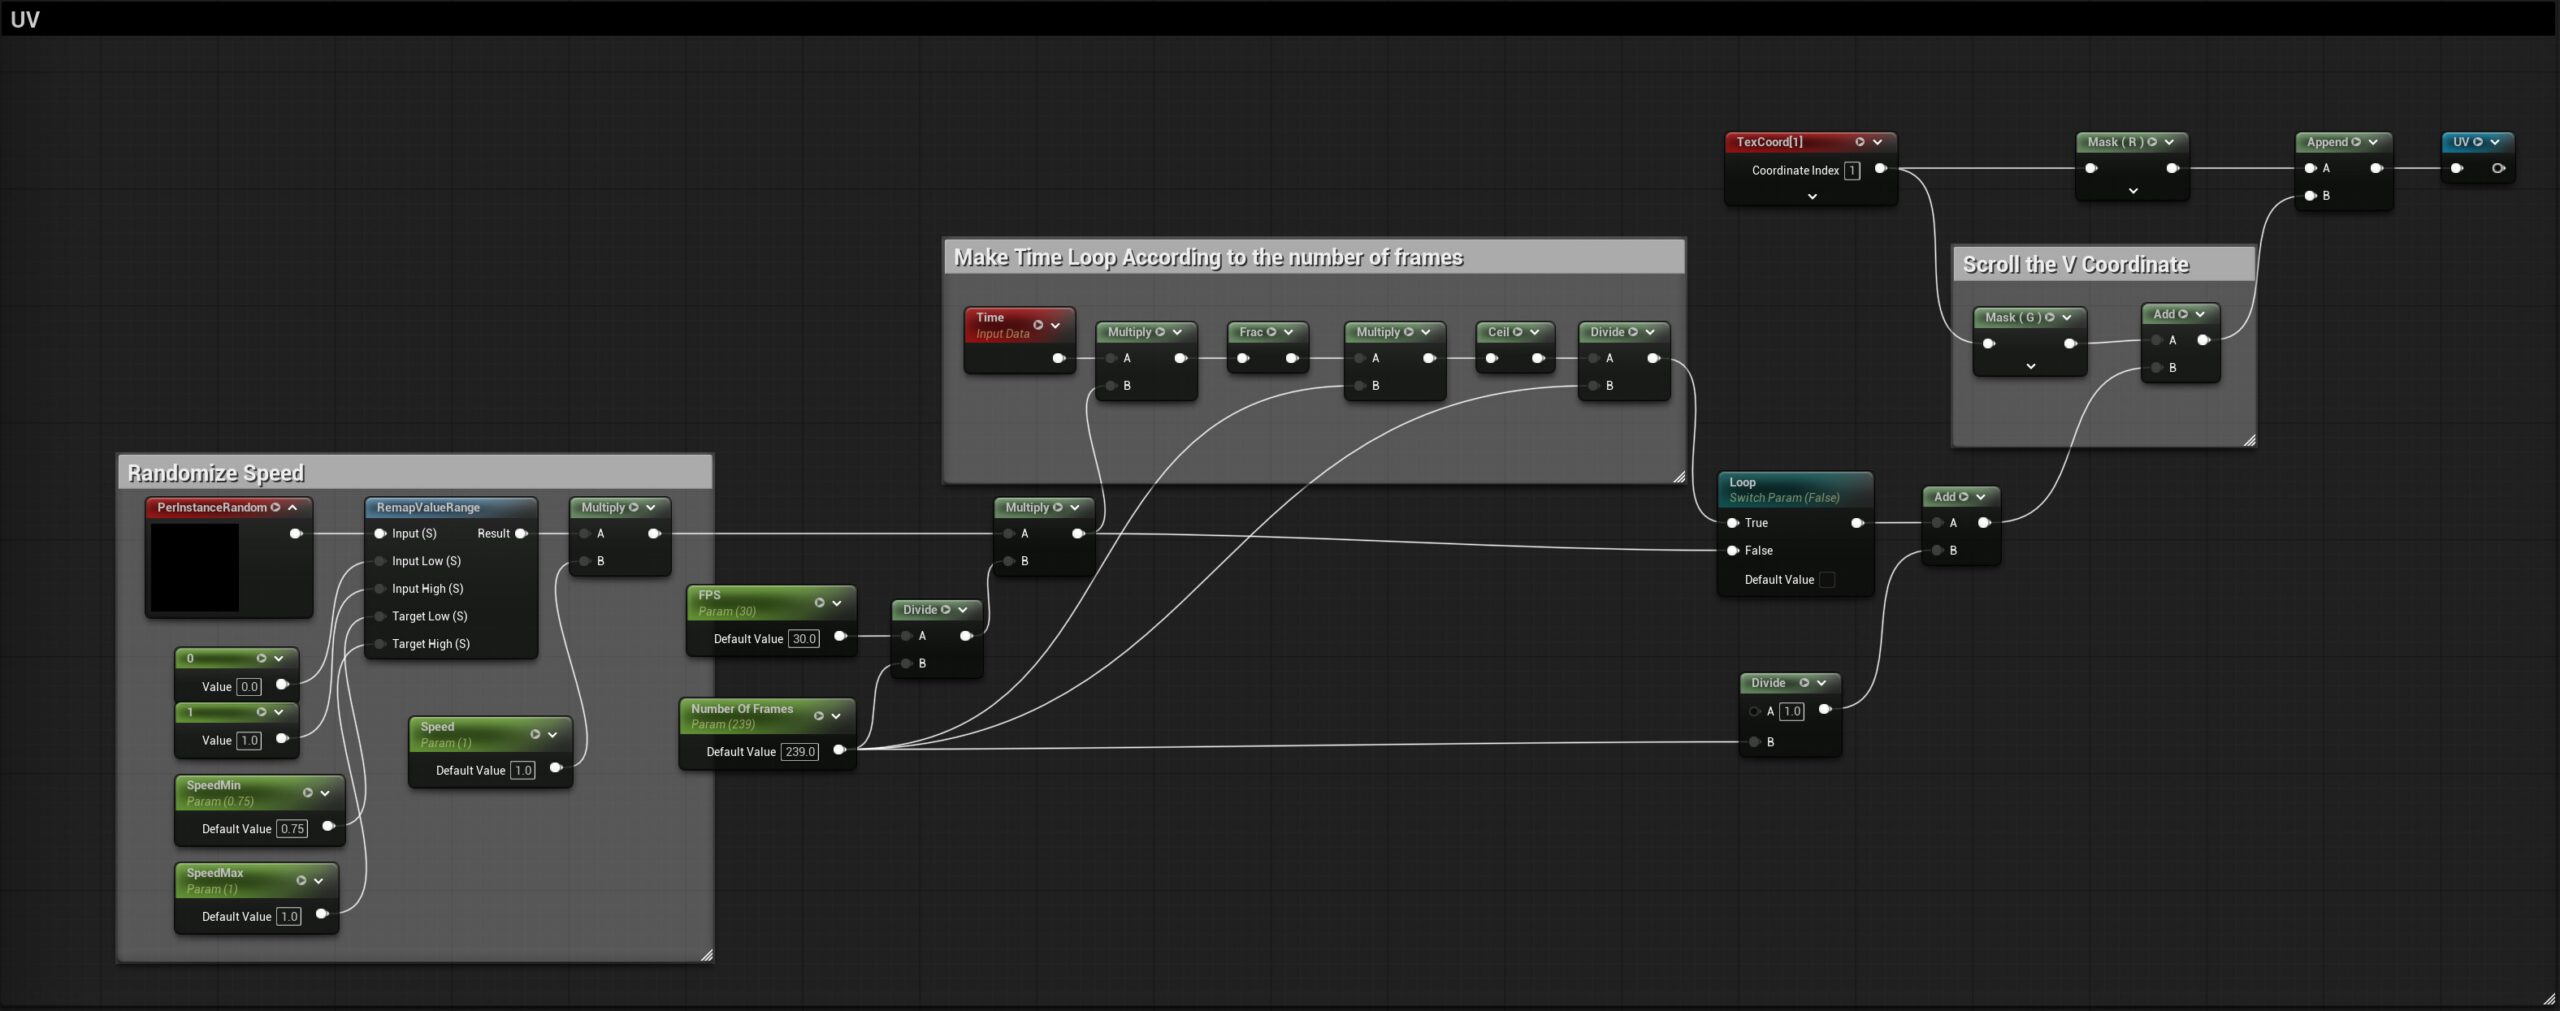
UV:在动画纹理上滚动
VAT 的核心机制是每个动画帧是纹理中的一行水平条带。要播放动画,着色器随时间向下滚动 V 坐标。UV 部分处理此操作,根据 FPS 和帧数参数构建时间循环,然后使用 PerInstanceRandom 偏移每个实例的开始时间,使它们不会同步动画。没有这一点,6000 个角色会被读取为单个平铺纹理,而不是独立的个体。
WPO:动态动画混合
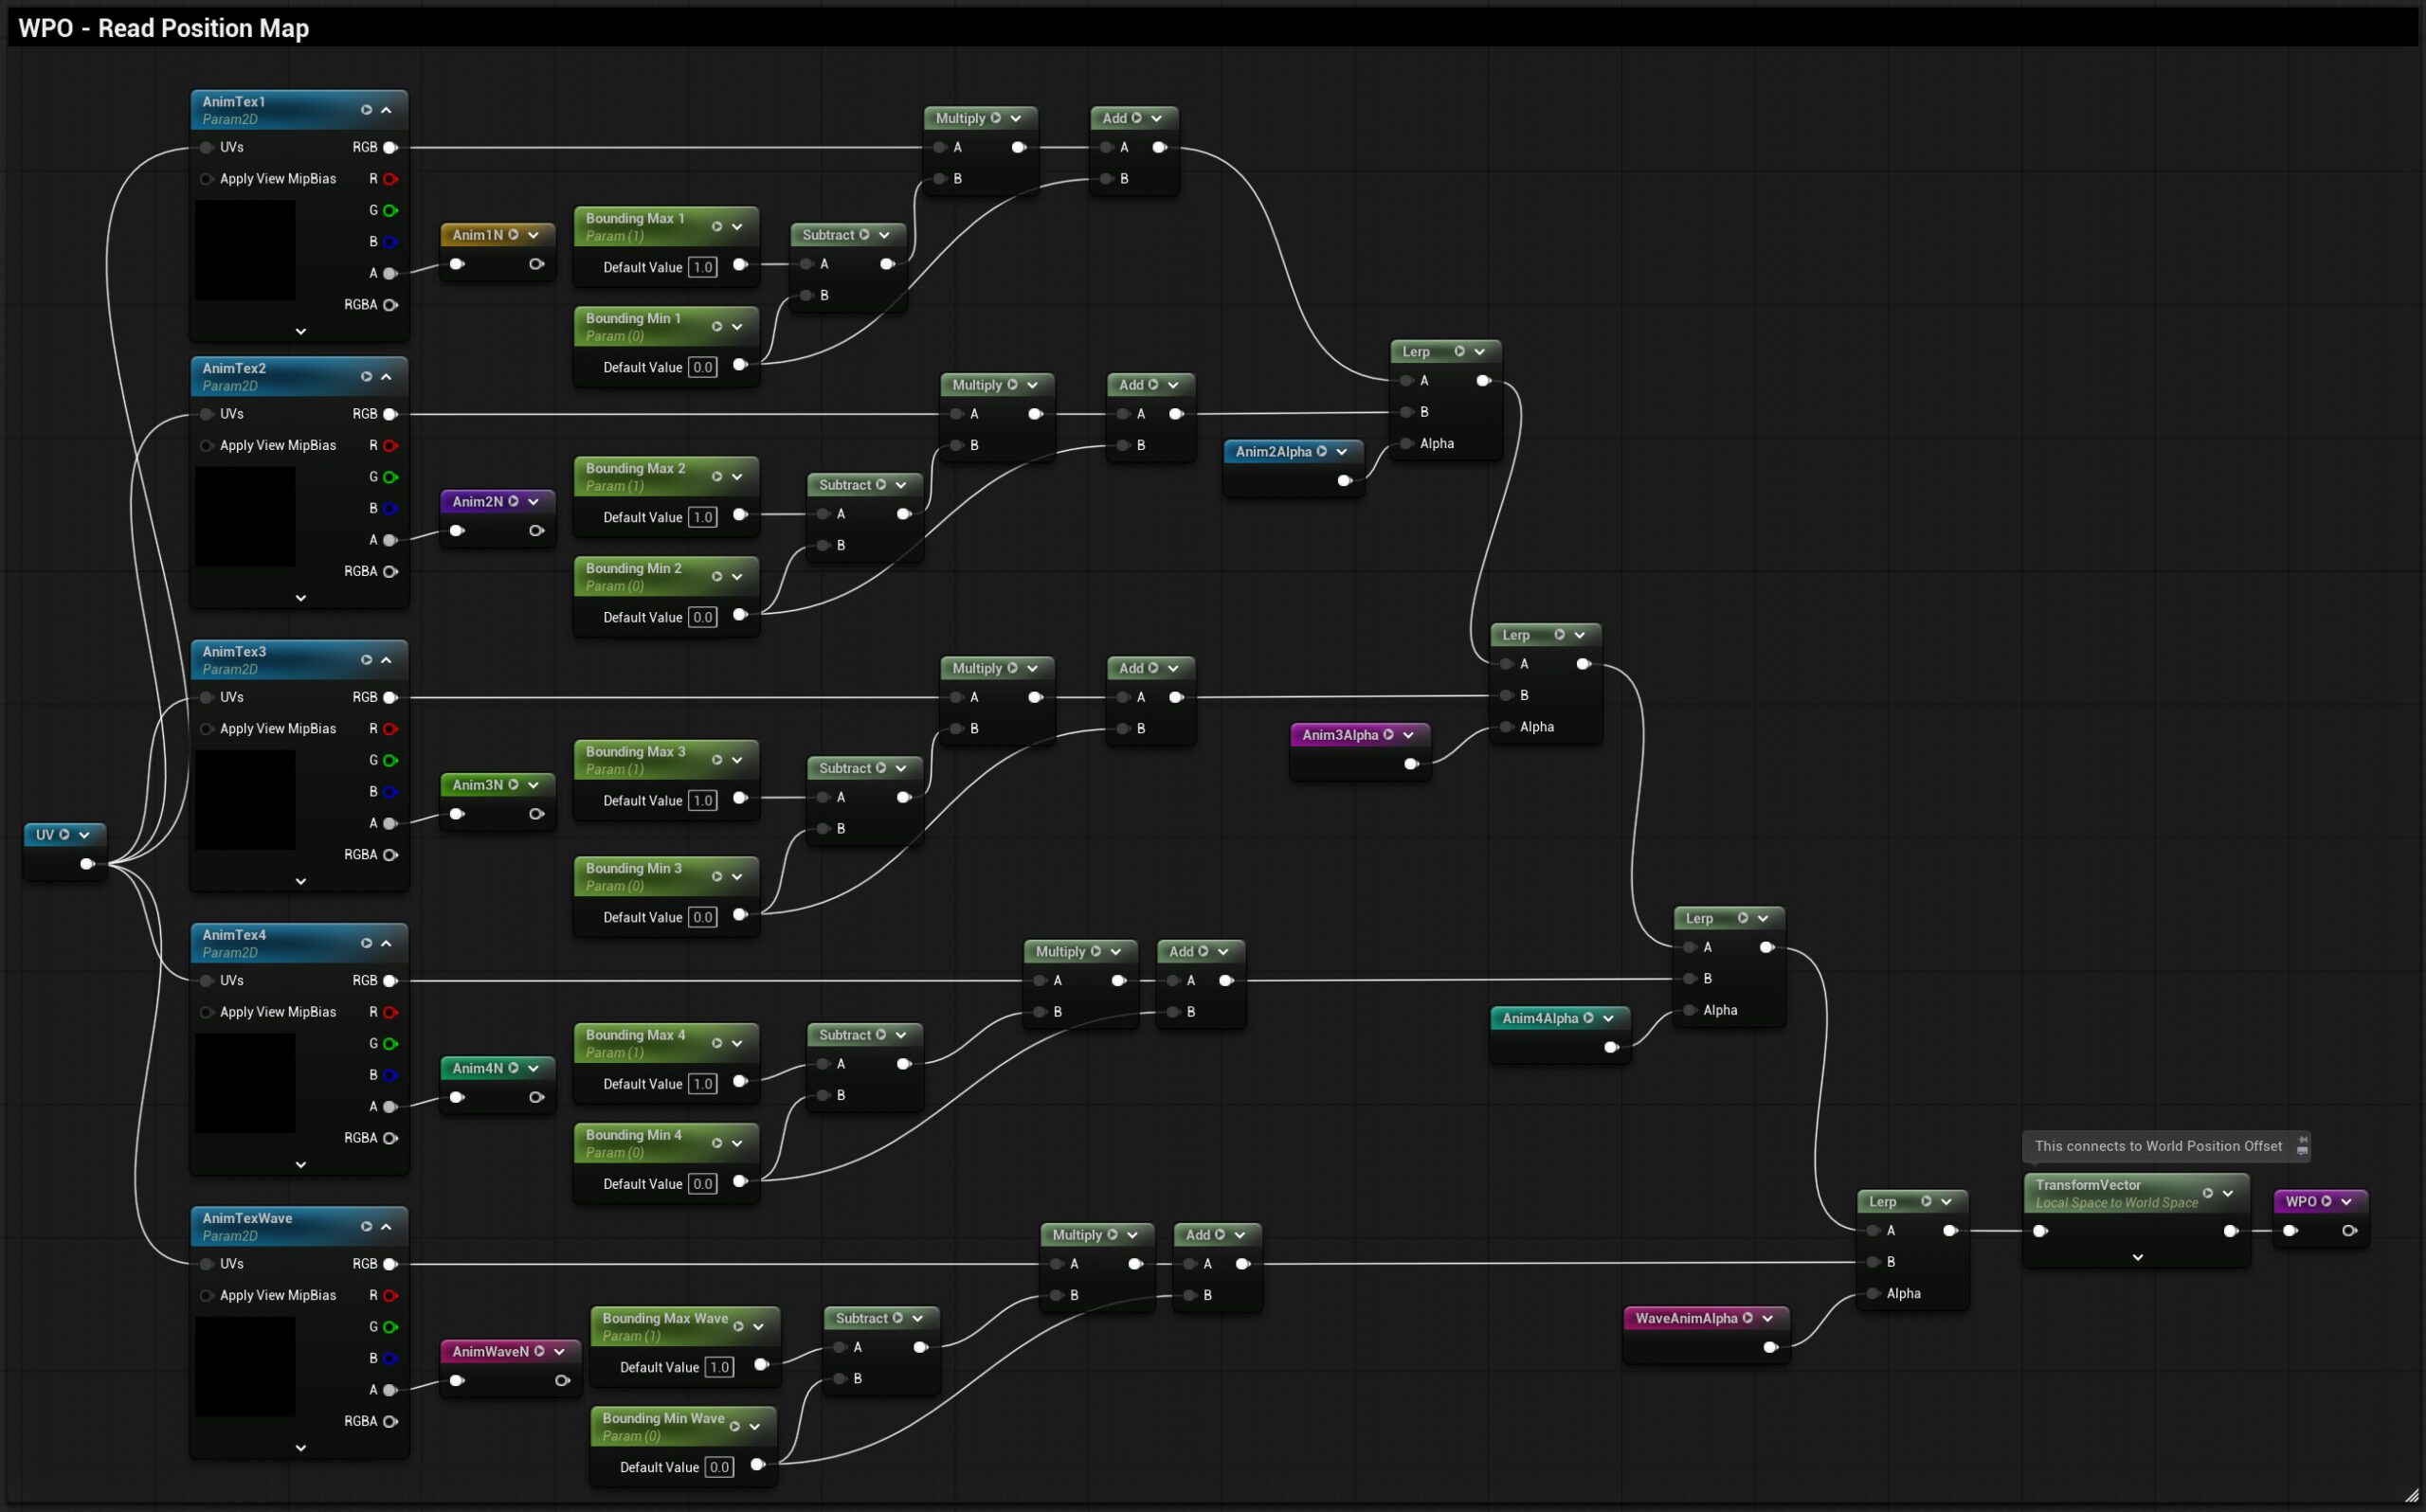
世界位置偏移(WPO)部分同时读取五张动画纹理(Anim1–Anim4 对应四个基础状态,加上 AnimWave)。每张纹理的 RGB 通道存储压缩后的位置偏移,并使用边界框最小/最大参数将其解压回世界空间值。随后,基于 UI 滑块驱动的 alpha 值,通过 Lerp 节点链在激活状态之间进行混合。
法线:解压压缩法线
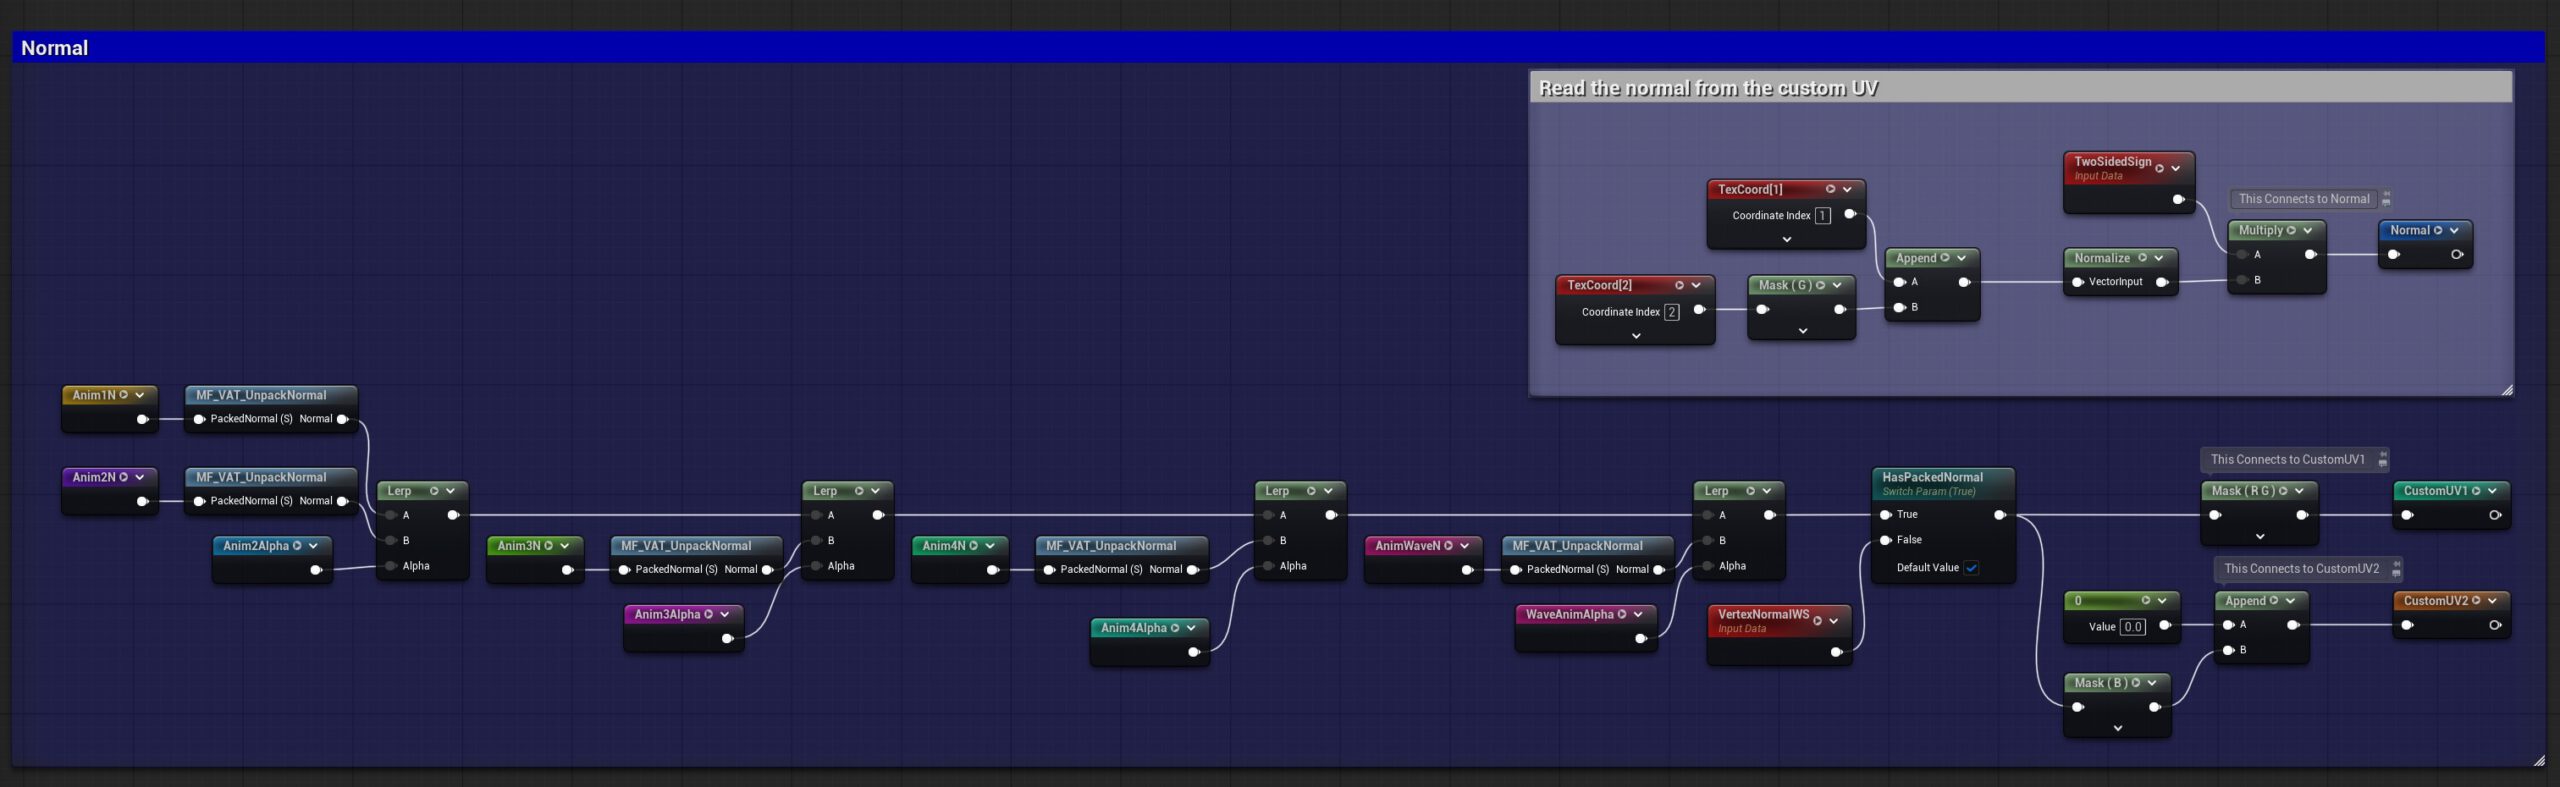
法线通过自定义材质函数 MF_VAT_UnpackNormal 解压,该函数从打包的 X 和 Y 值重建 Z 分量,然后与 WPO 混合同步进行 Lerp。WPO 部分中的相同 Lerp 链在此处镜像,以保持法线与动画位置一致。
人浪:GPU 驱动的体育场人浪
人浪行为是该系统的亮点。触发时,整个体育场的观众按顺序起立,形成经典的涟漪式“人浪”效果。关键在于,这是完全在着色器中计算的,通过为每个代理计算相对于其在体育场中的位置或 GlobalID 的唯一开始时间。
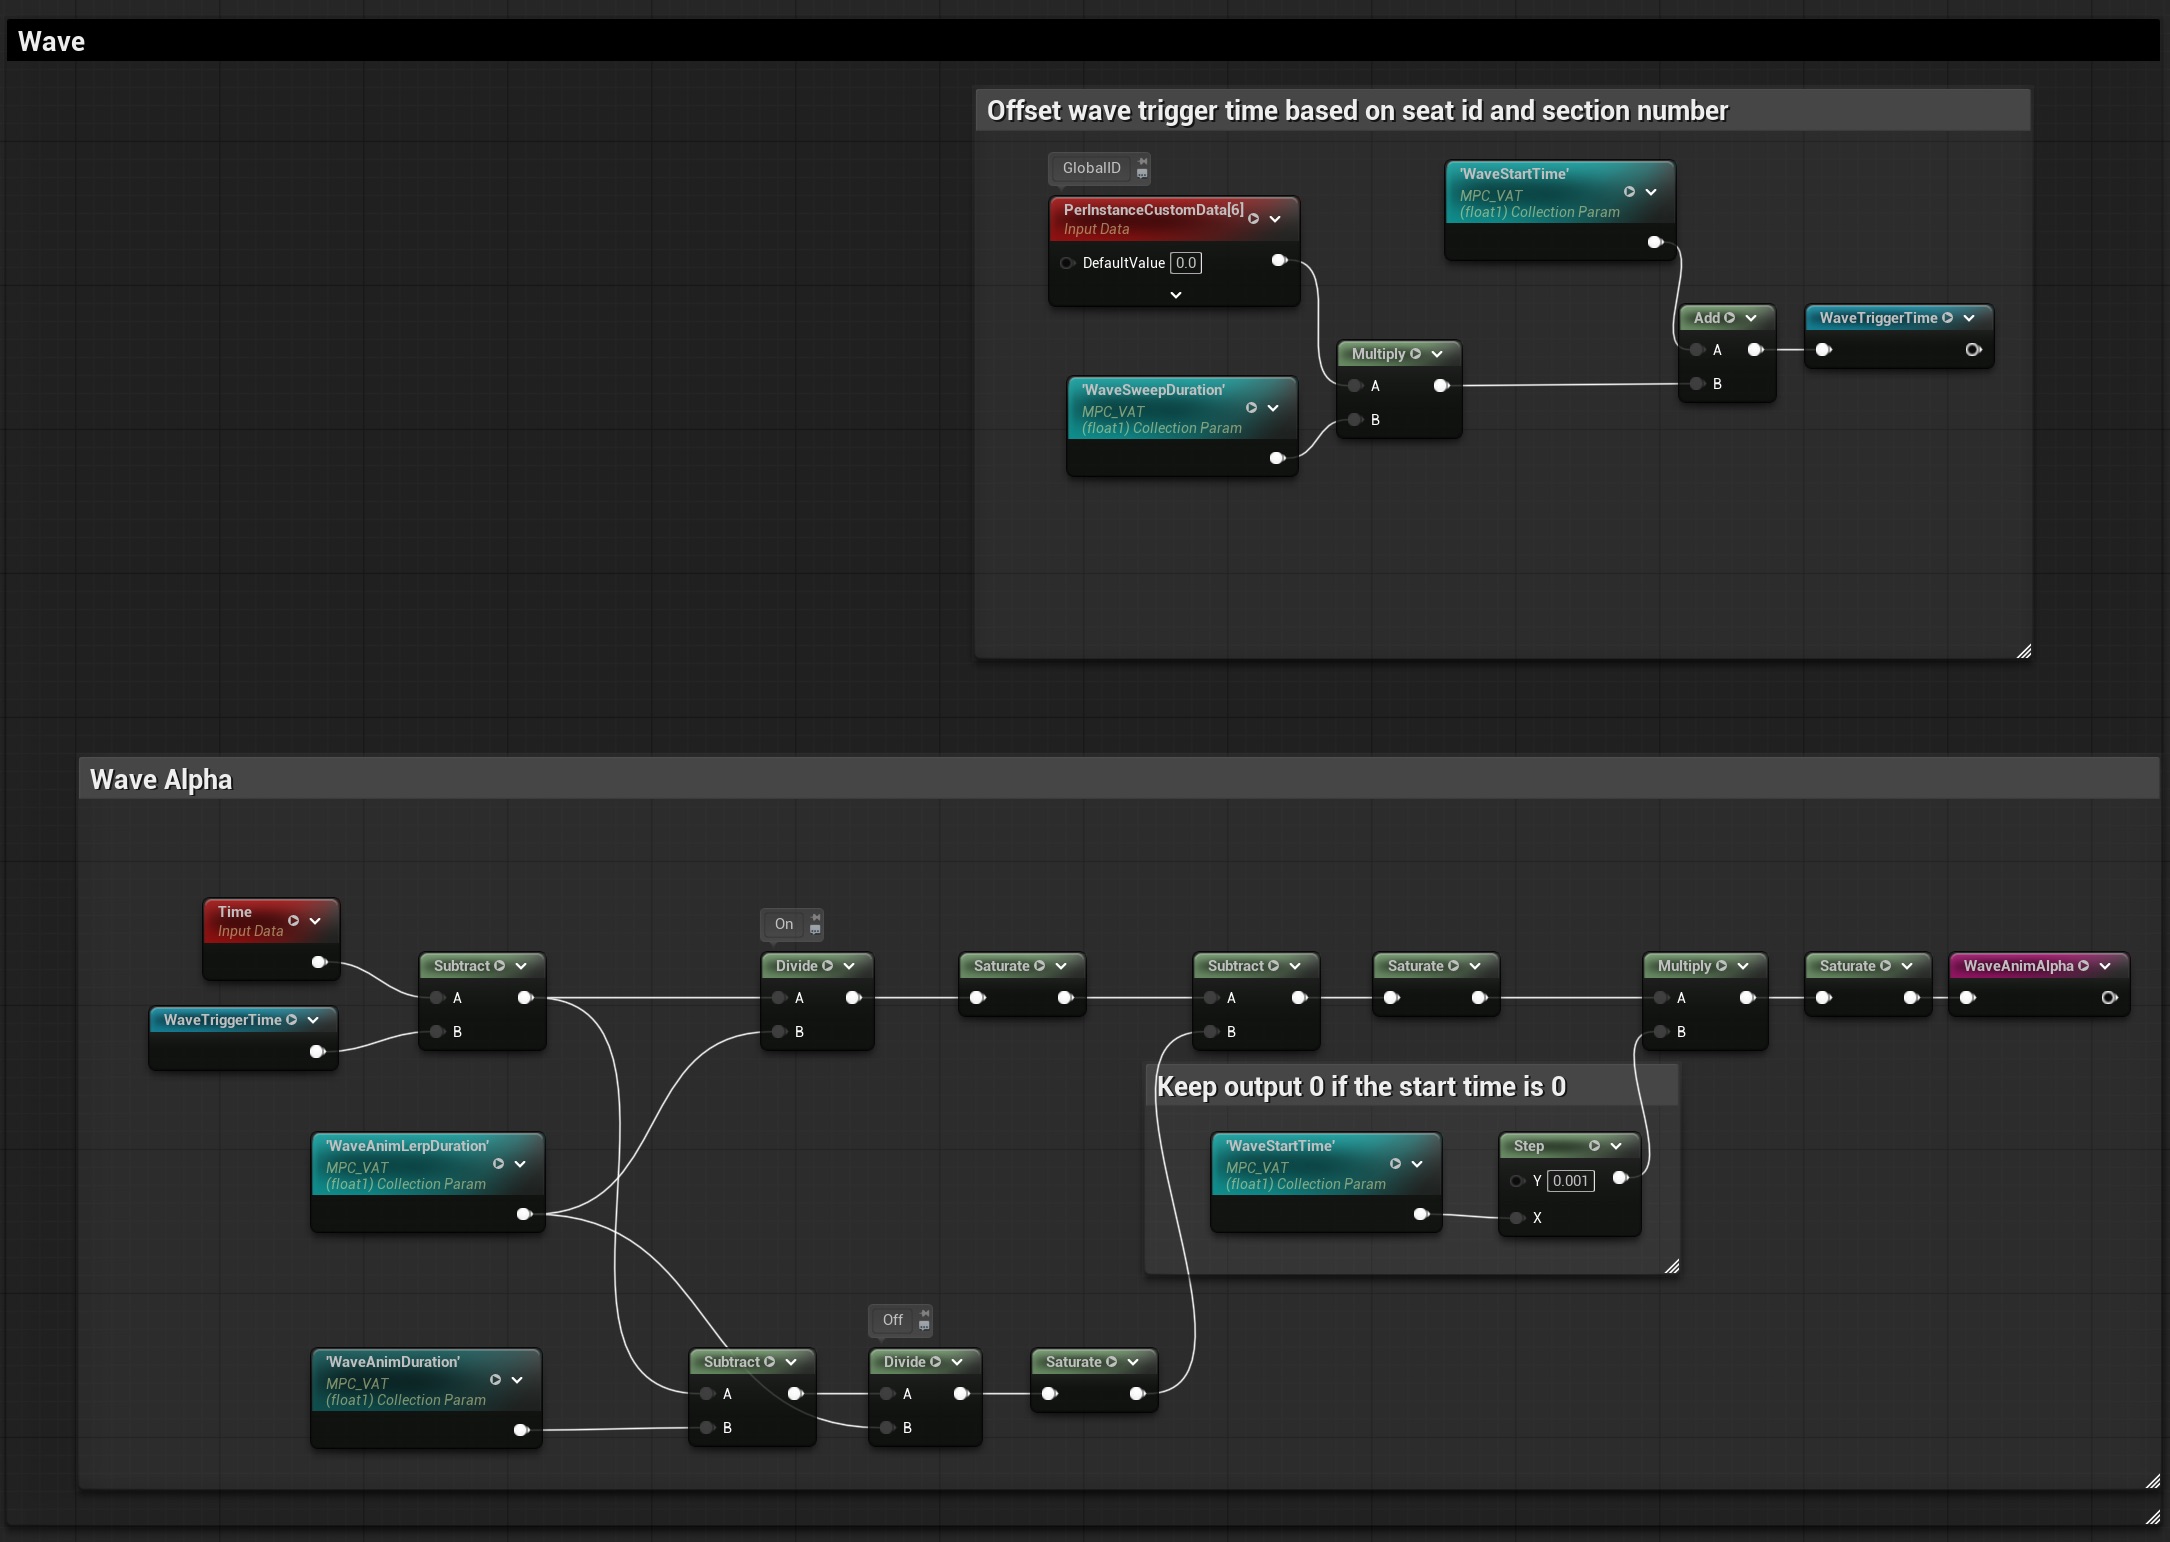
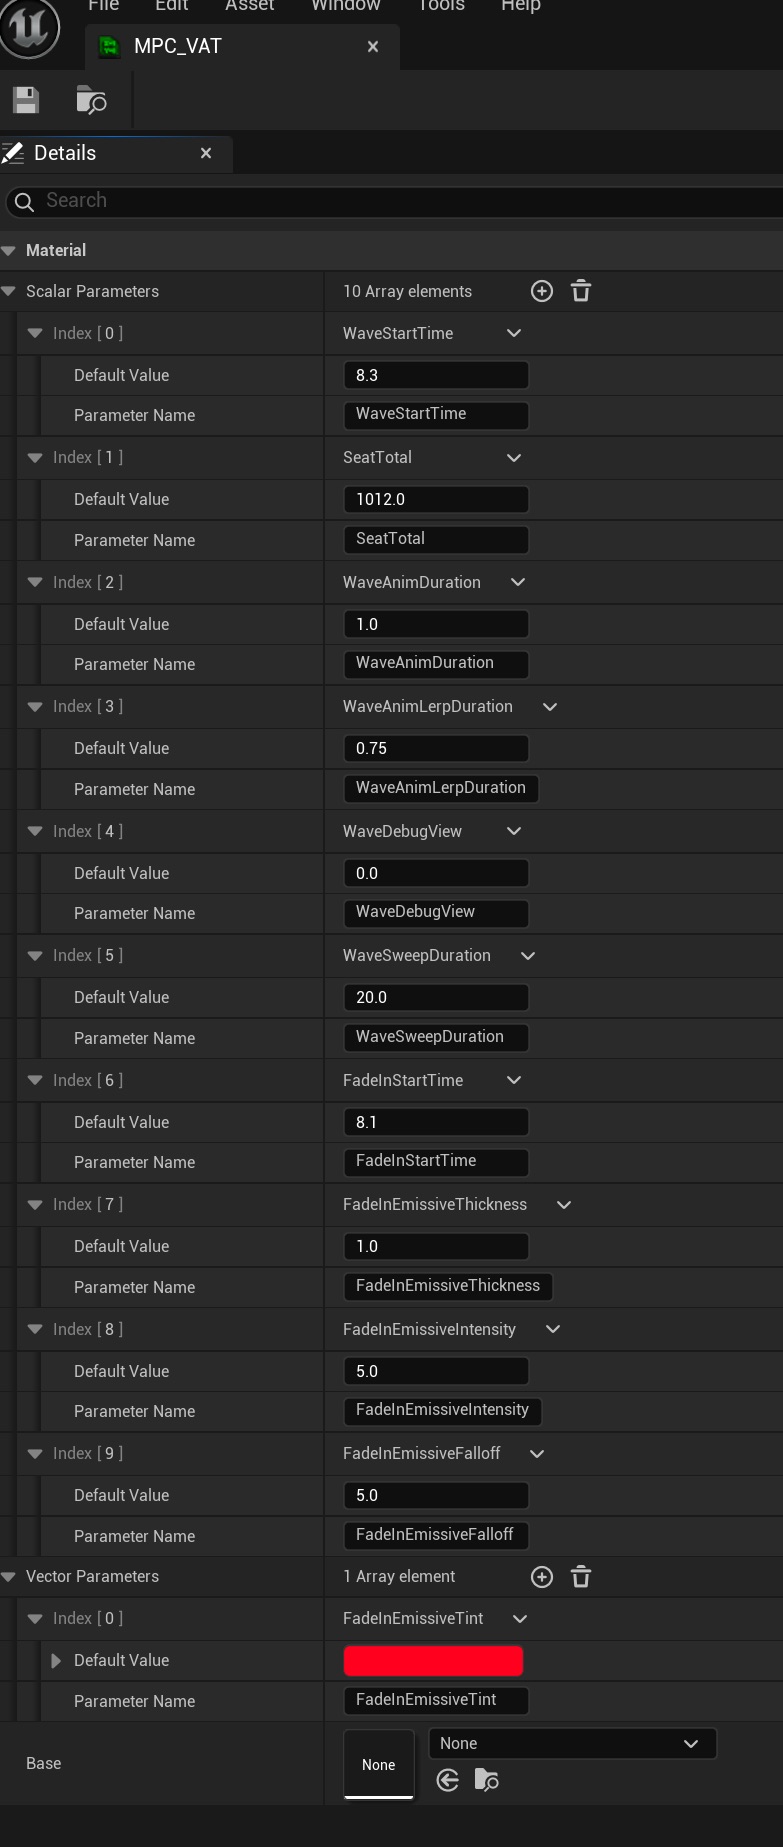
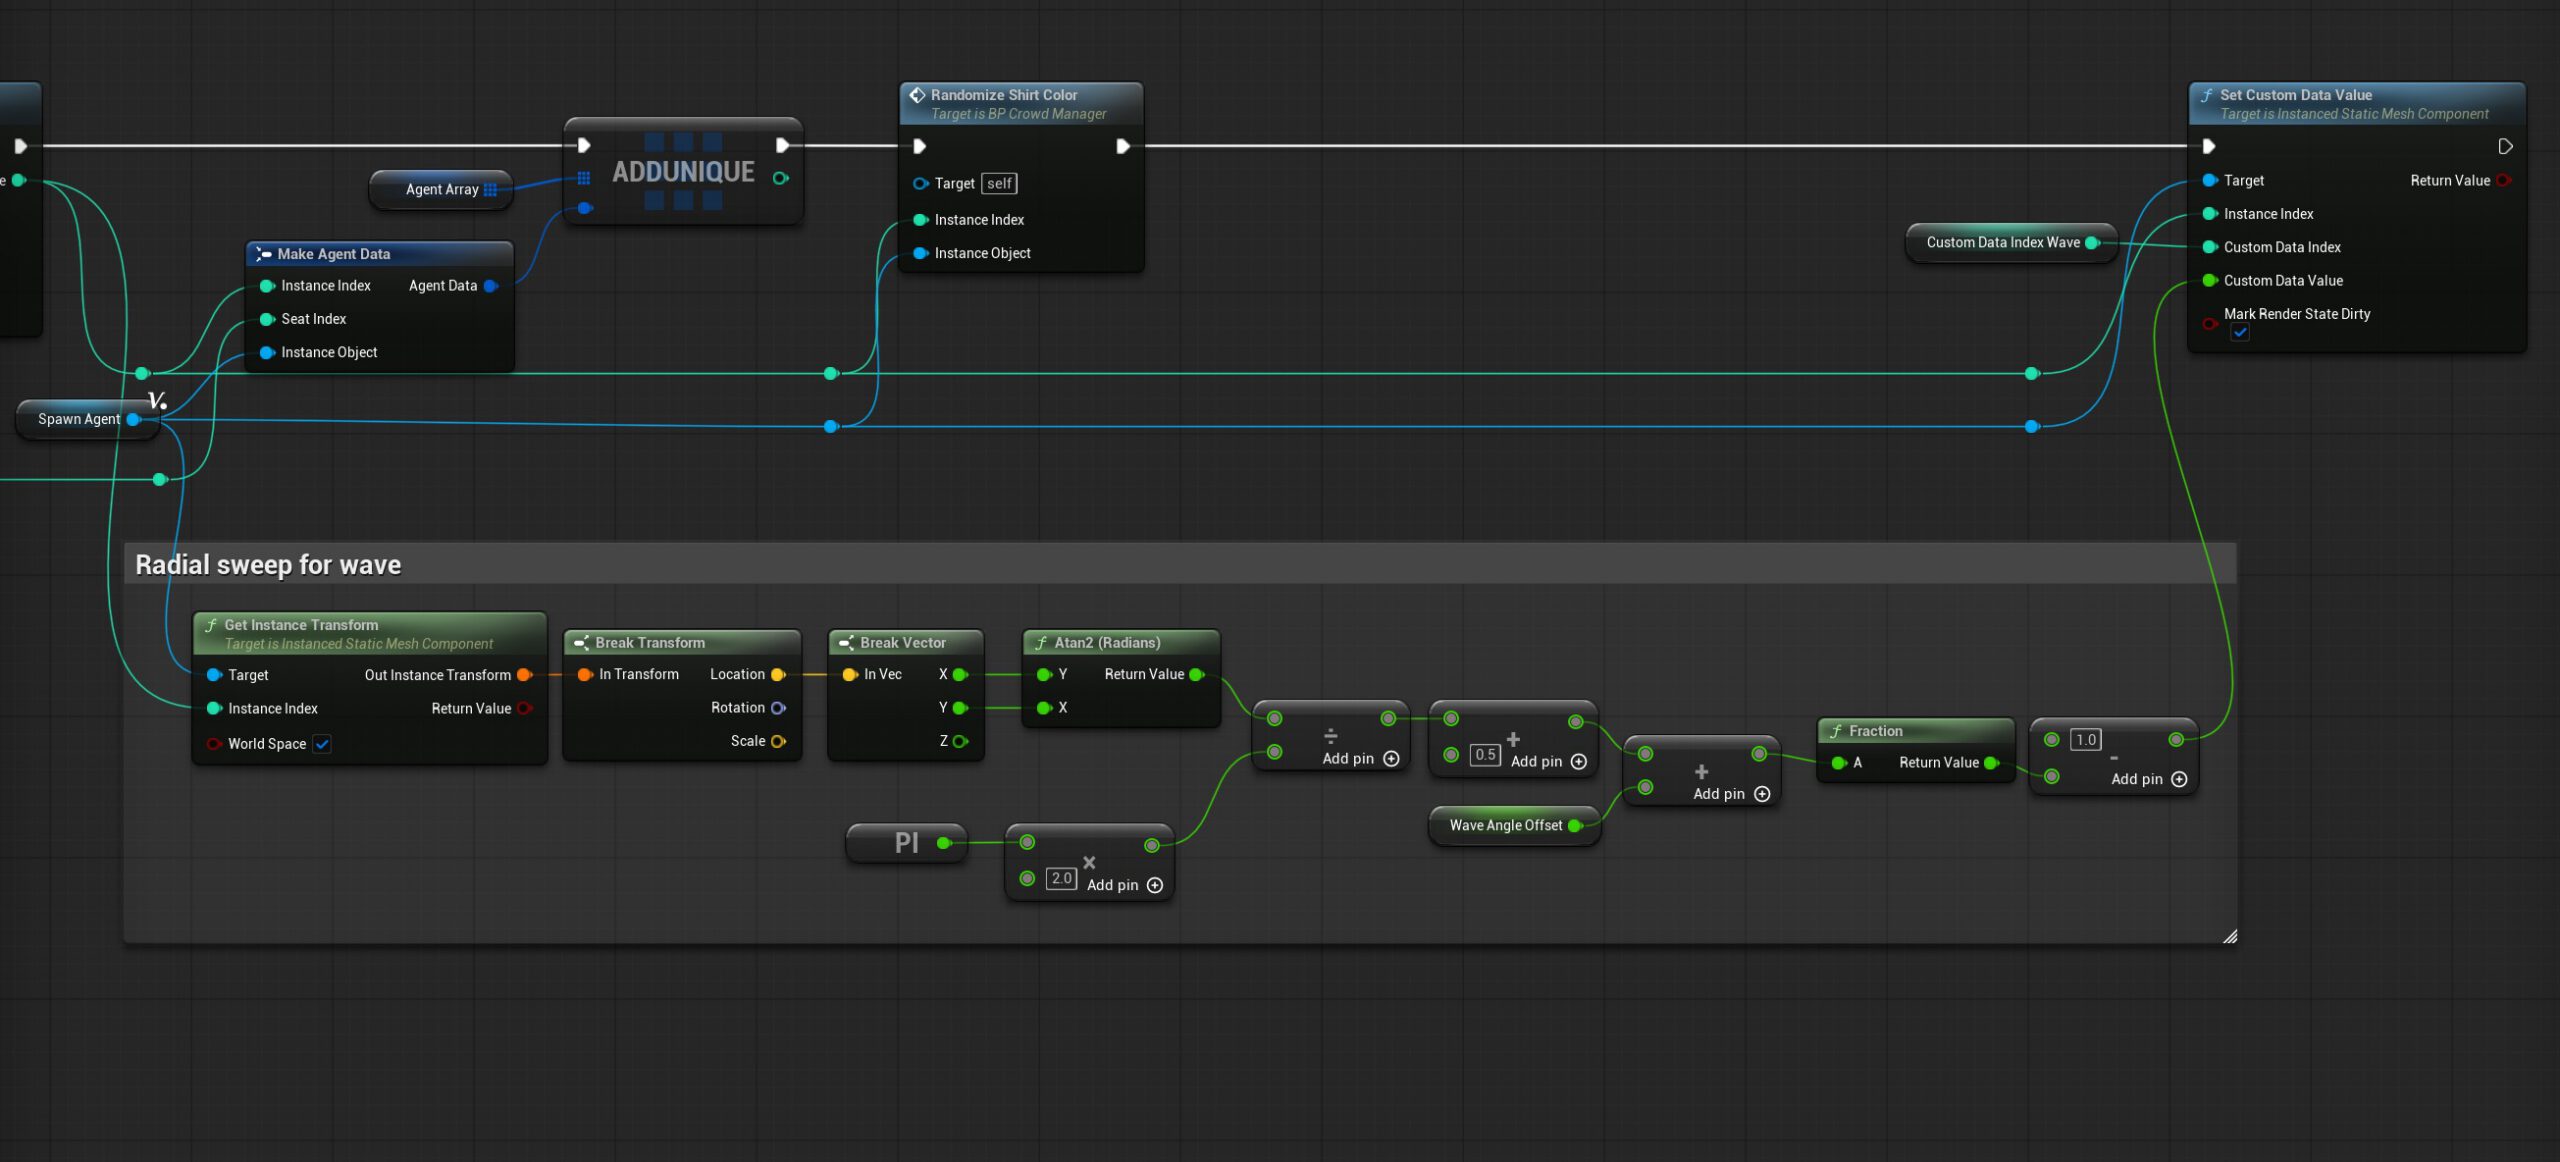
MPC_VAT(材质参数集合)保存全局变量:WaveStartTime(人浪触发时间)和WaveSweepDuration(整场扫过所需时间)。每个实例将其唯一的GlobalID存储在PerInstanceCustomData[6]中。着色器的 Wave 部分使用此 ID 计算个性化的触发时间:
WaveTriggerTime = (GlobalID × WaveSweepDuration) + WaveStartTime
当材质的Time节点超过WaveTriggerTime时,WaveAnimAlpha从 0 插值到 1,将实例从当前动画平滑混合到人浪 VAT 行。
基础颜色
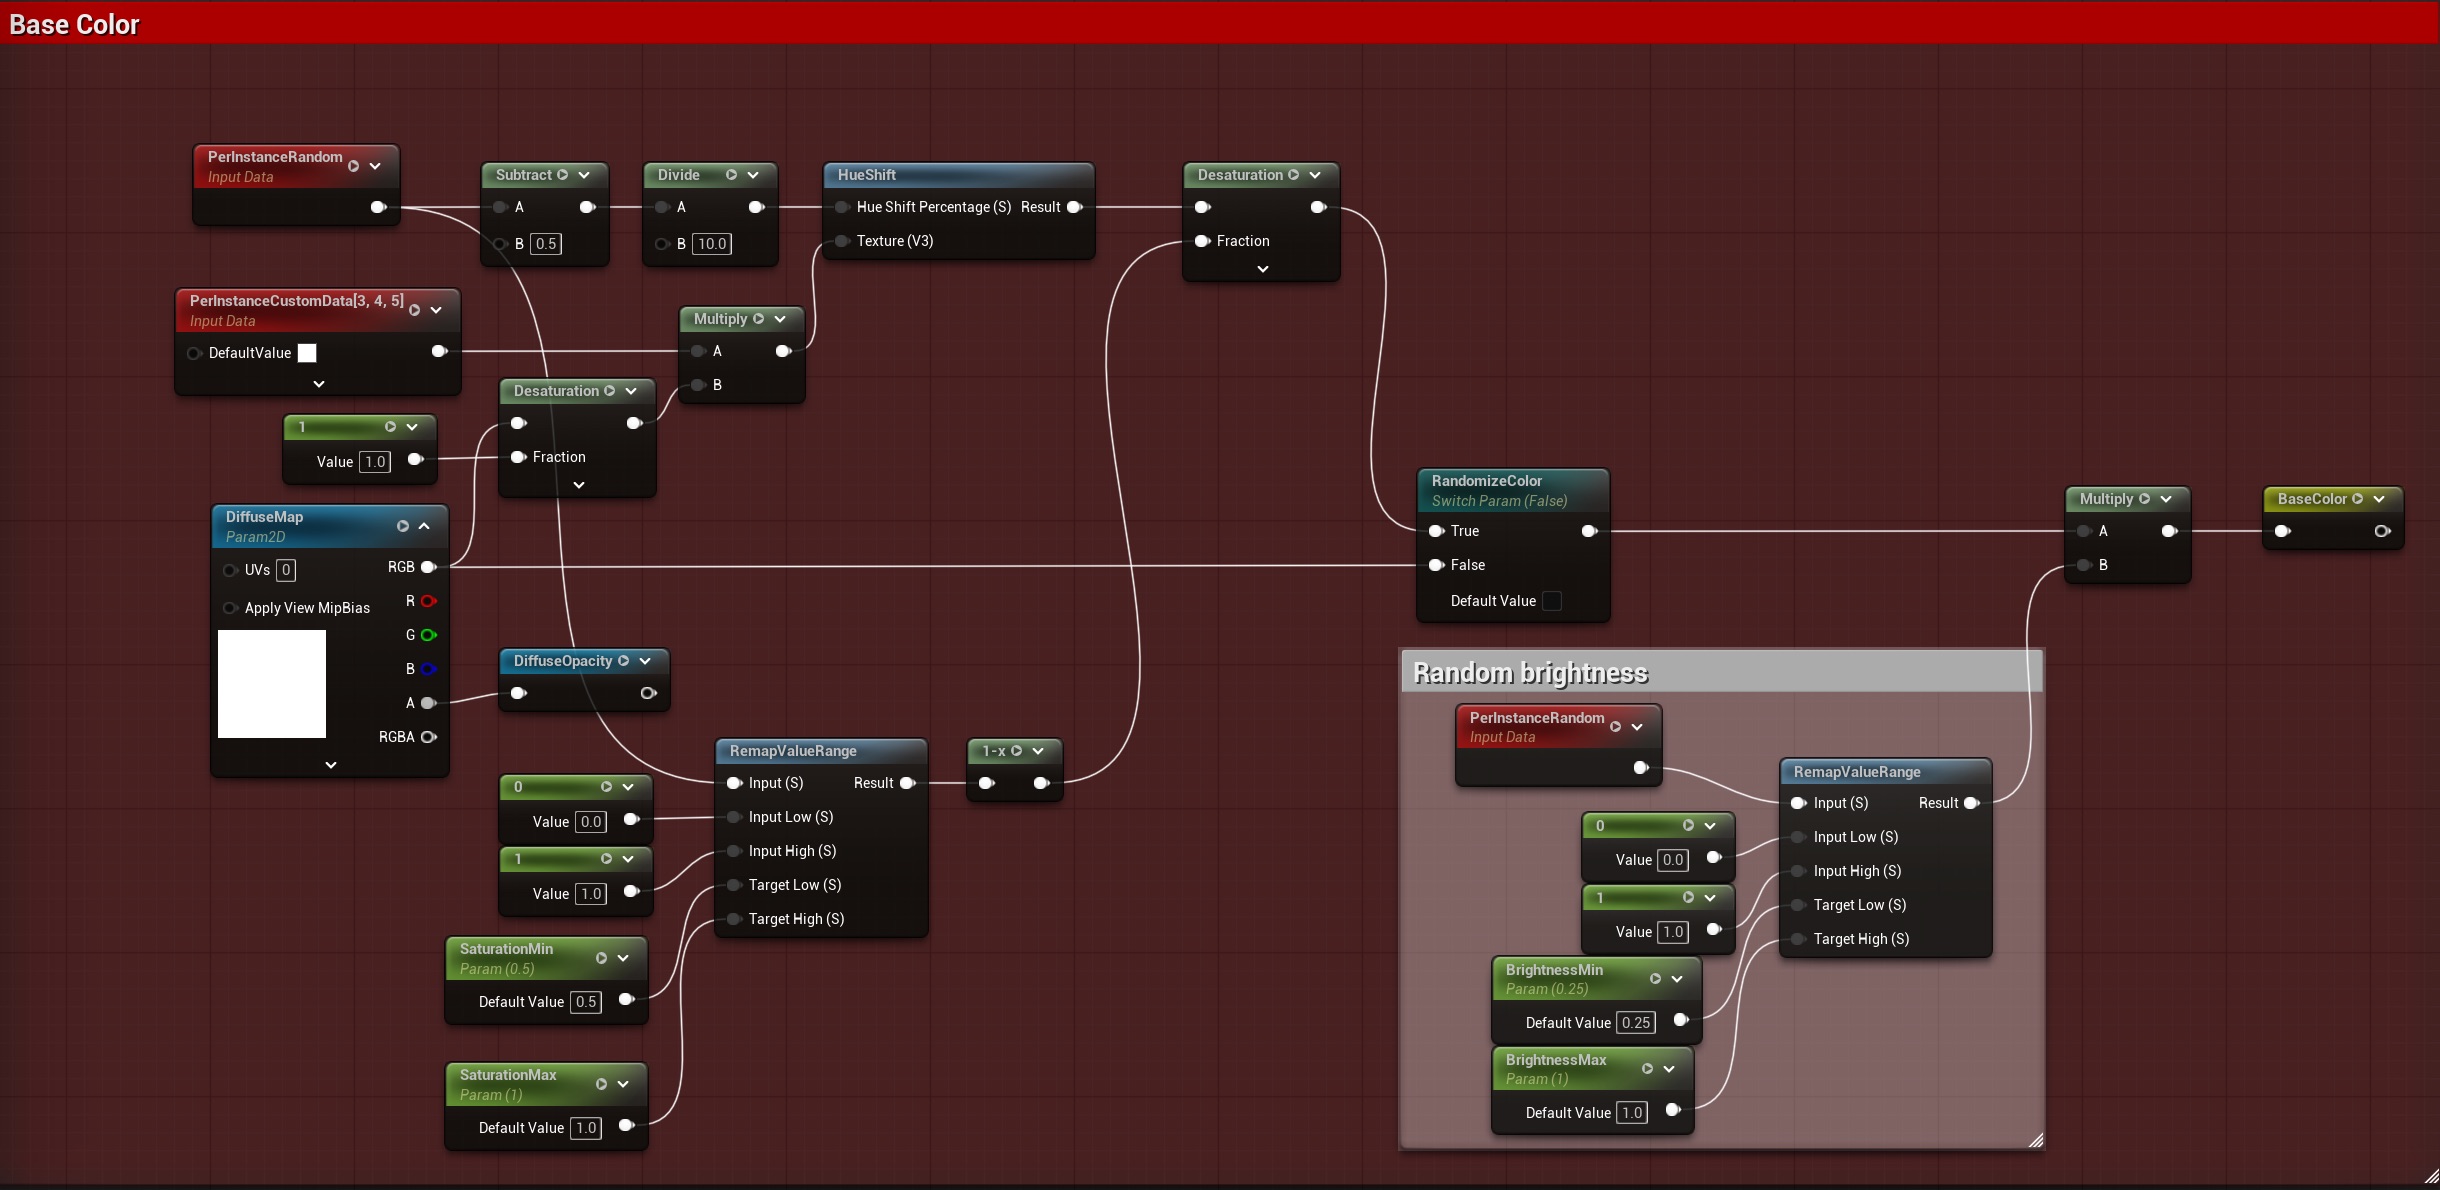
基础颜色随机化确保相邻的观众不会有相同的服装颜色。PerInstanceRandom 驱动漫反射纹理的色相偏移,而单独的 PerInstanceCustomData[3,4,5] 槽存储由蓝图在生成时设置的衬衫颜色,允许 CPU 在生成时一次性设置颜色,而不是每帧重新计算。
第四部分:蓝图生成和 UI 逻辑
CrowdManager 蓝图
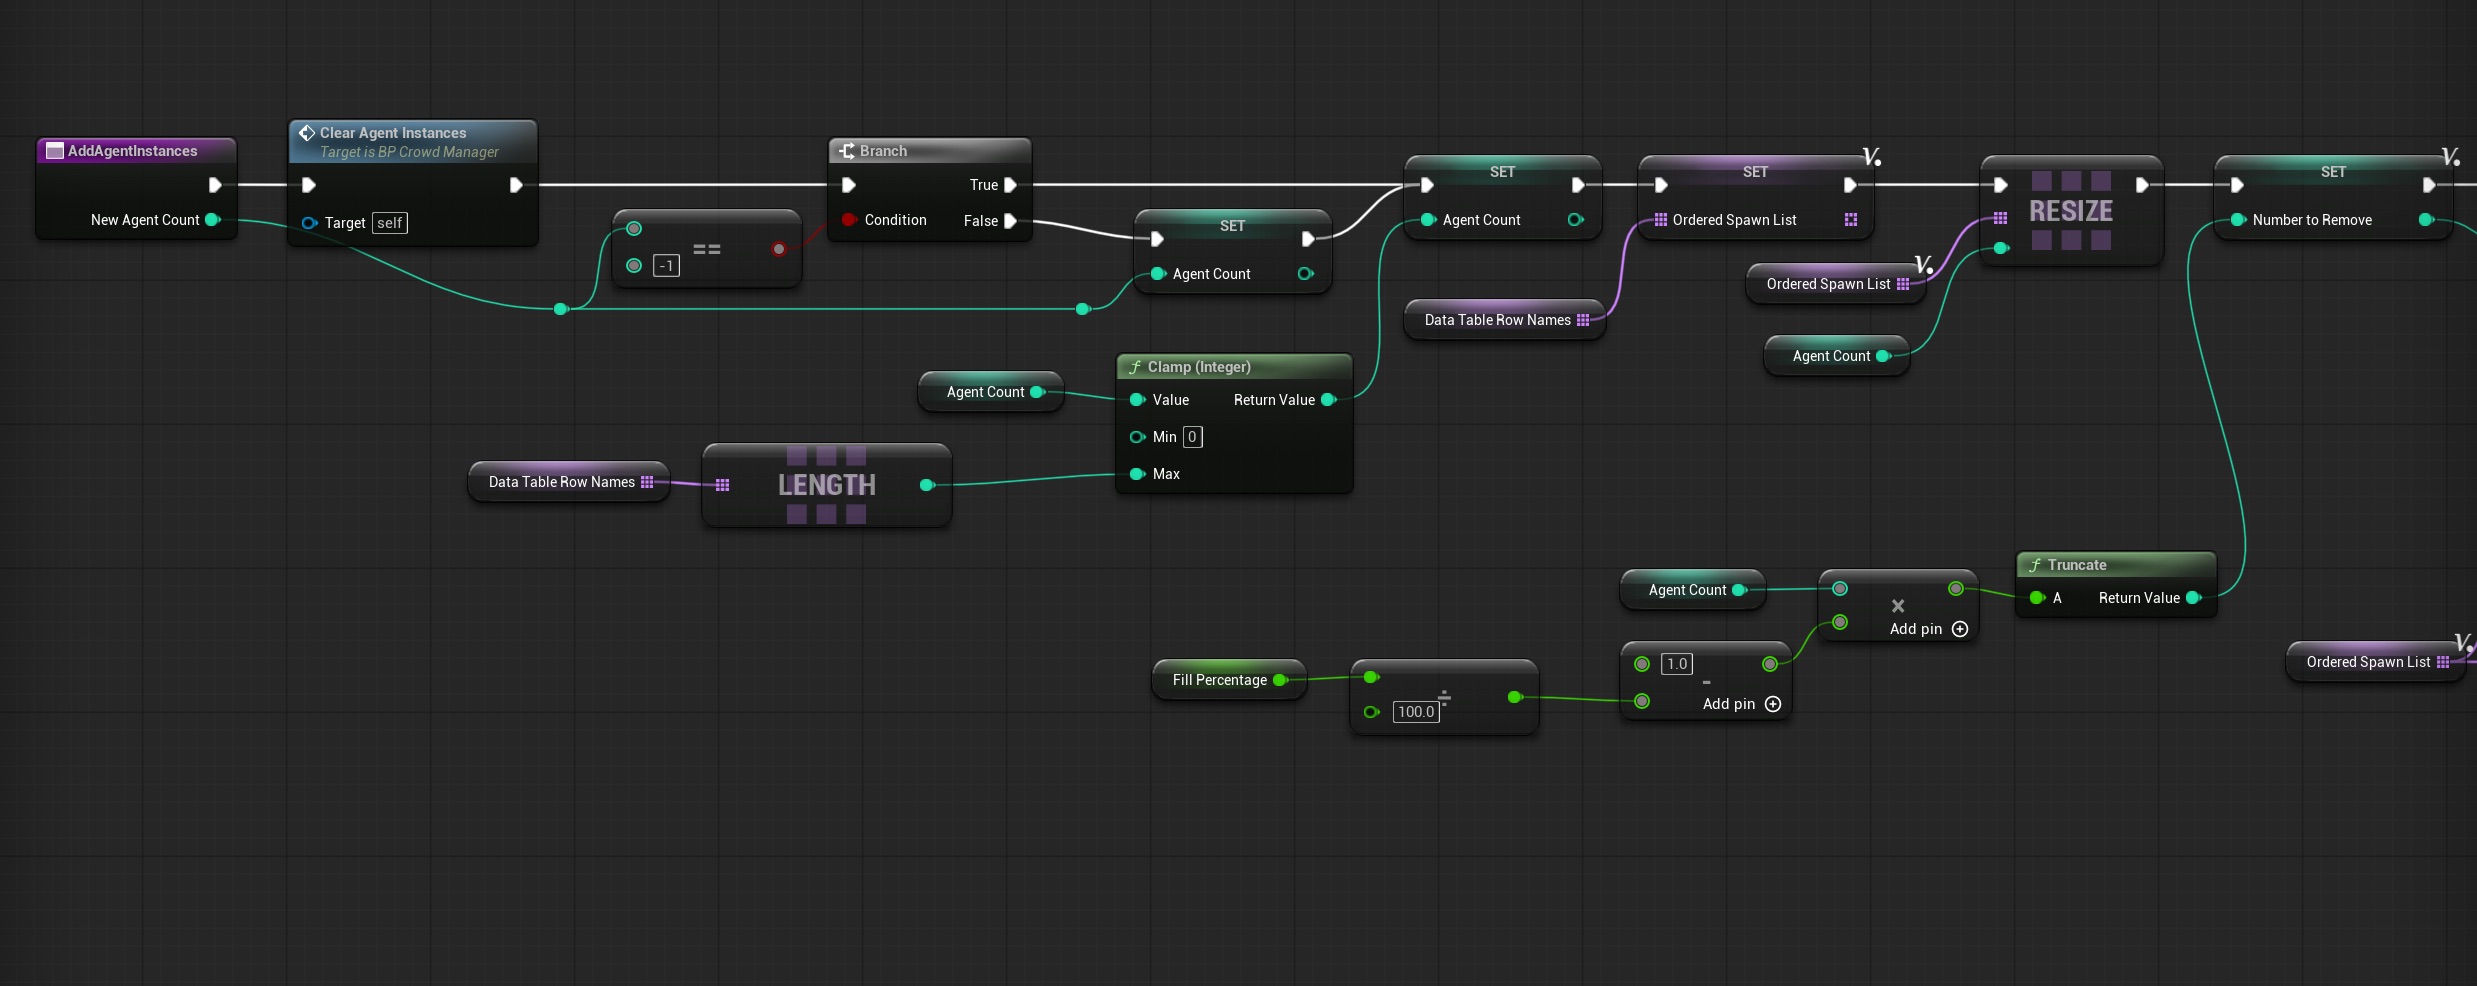
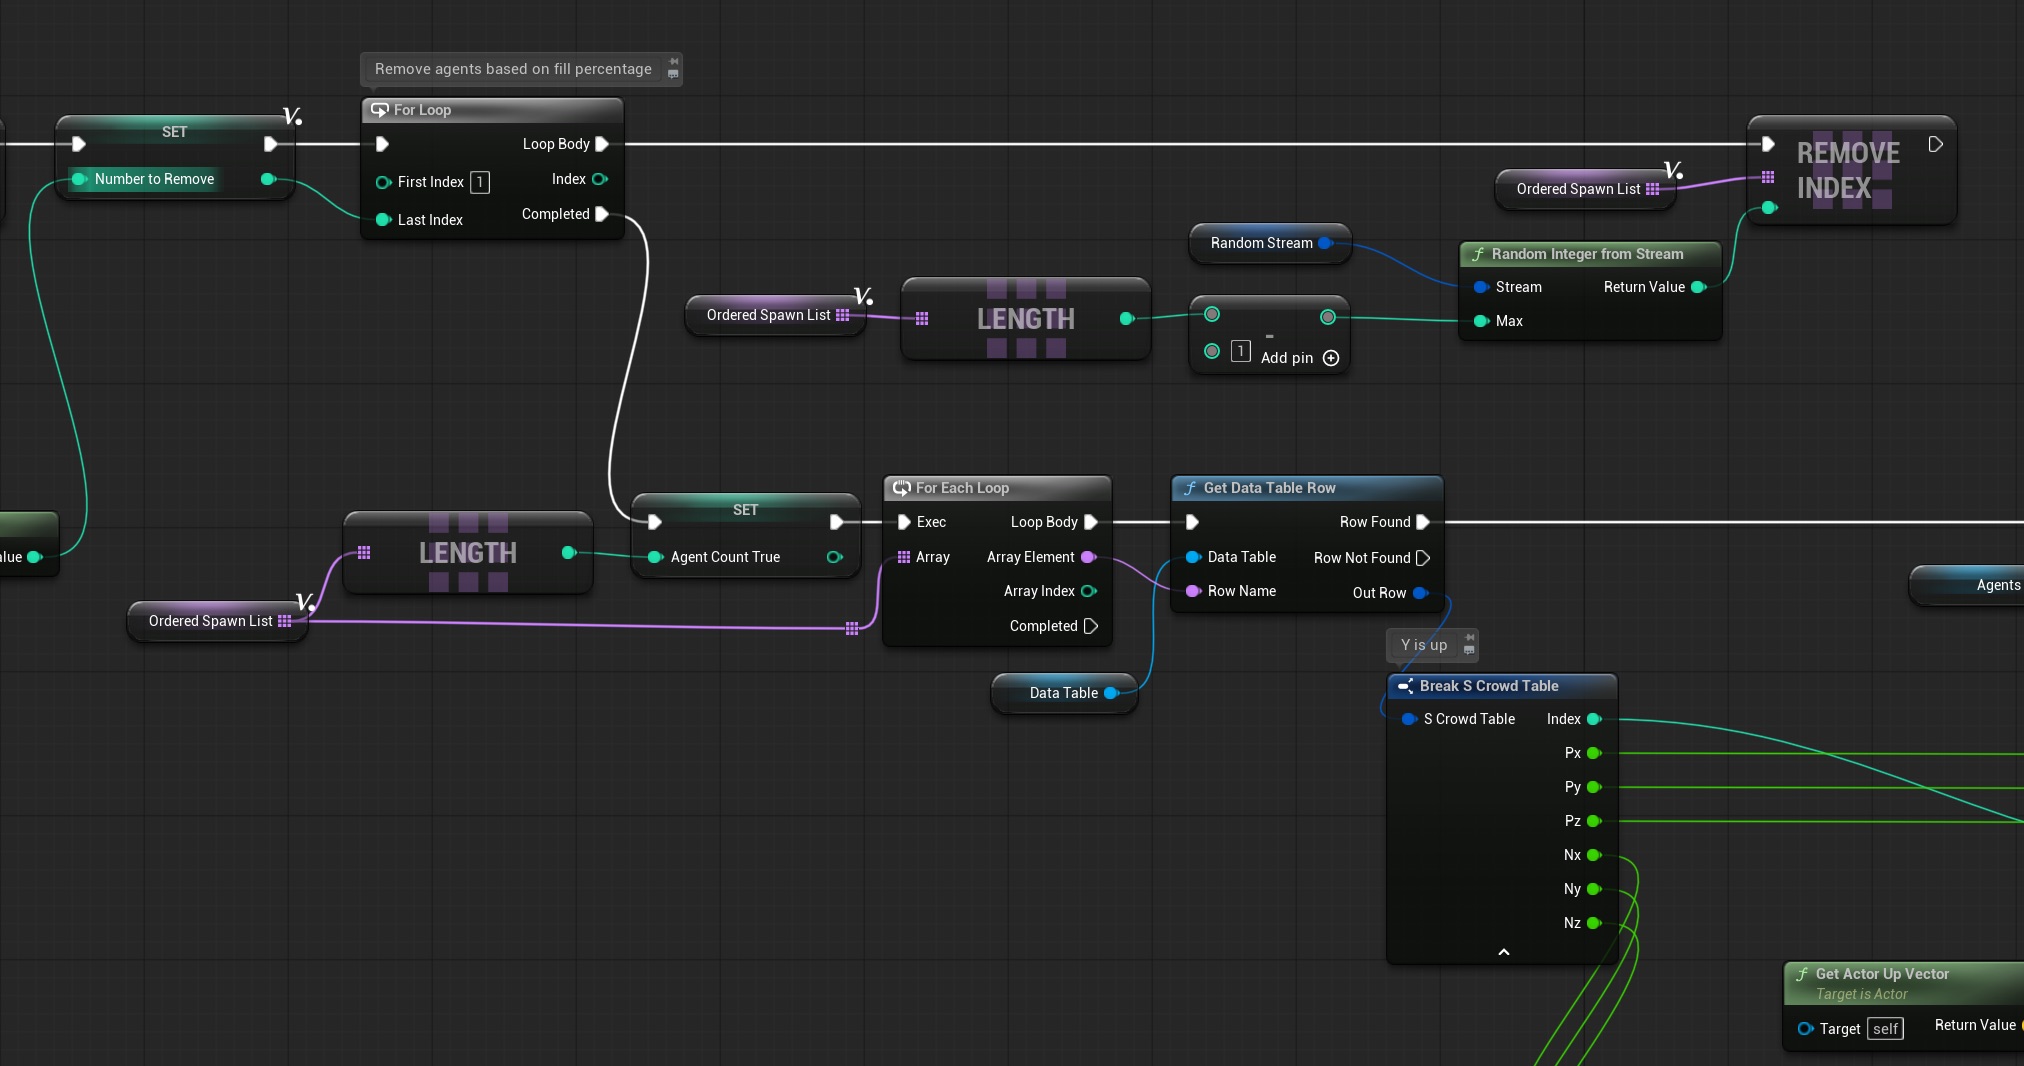
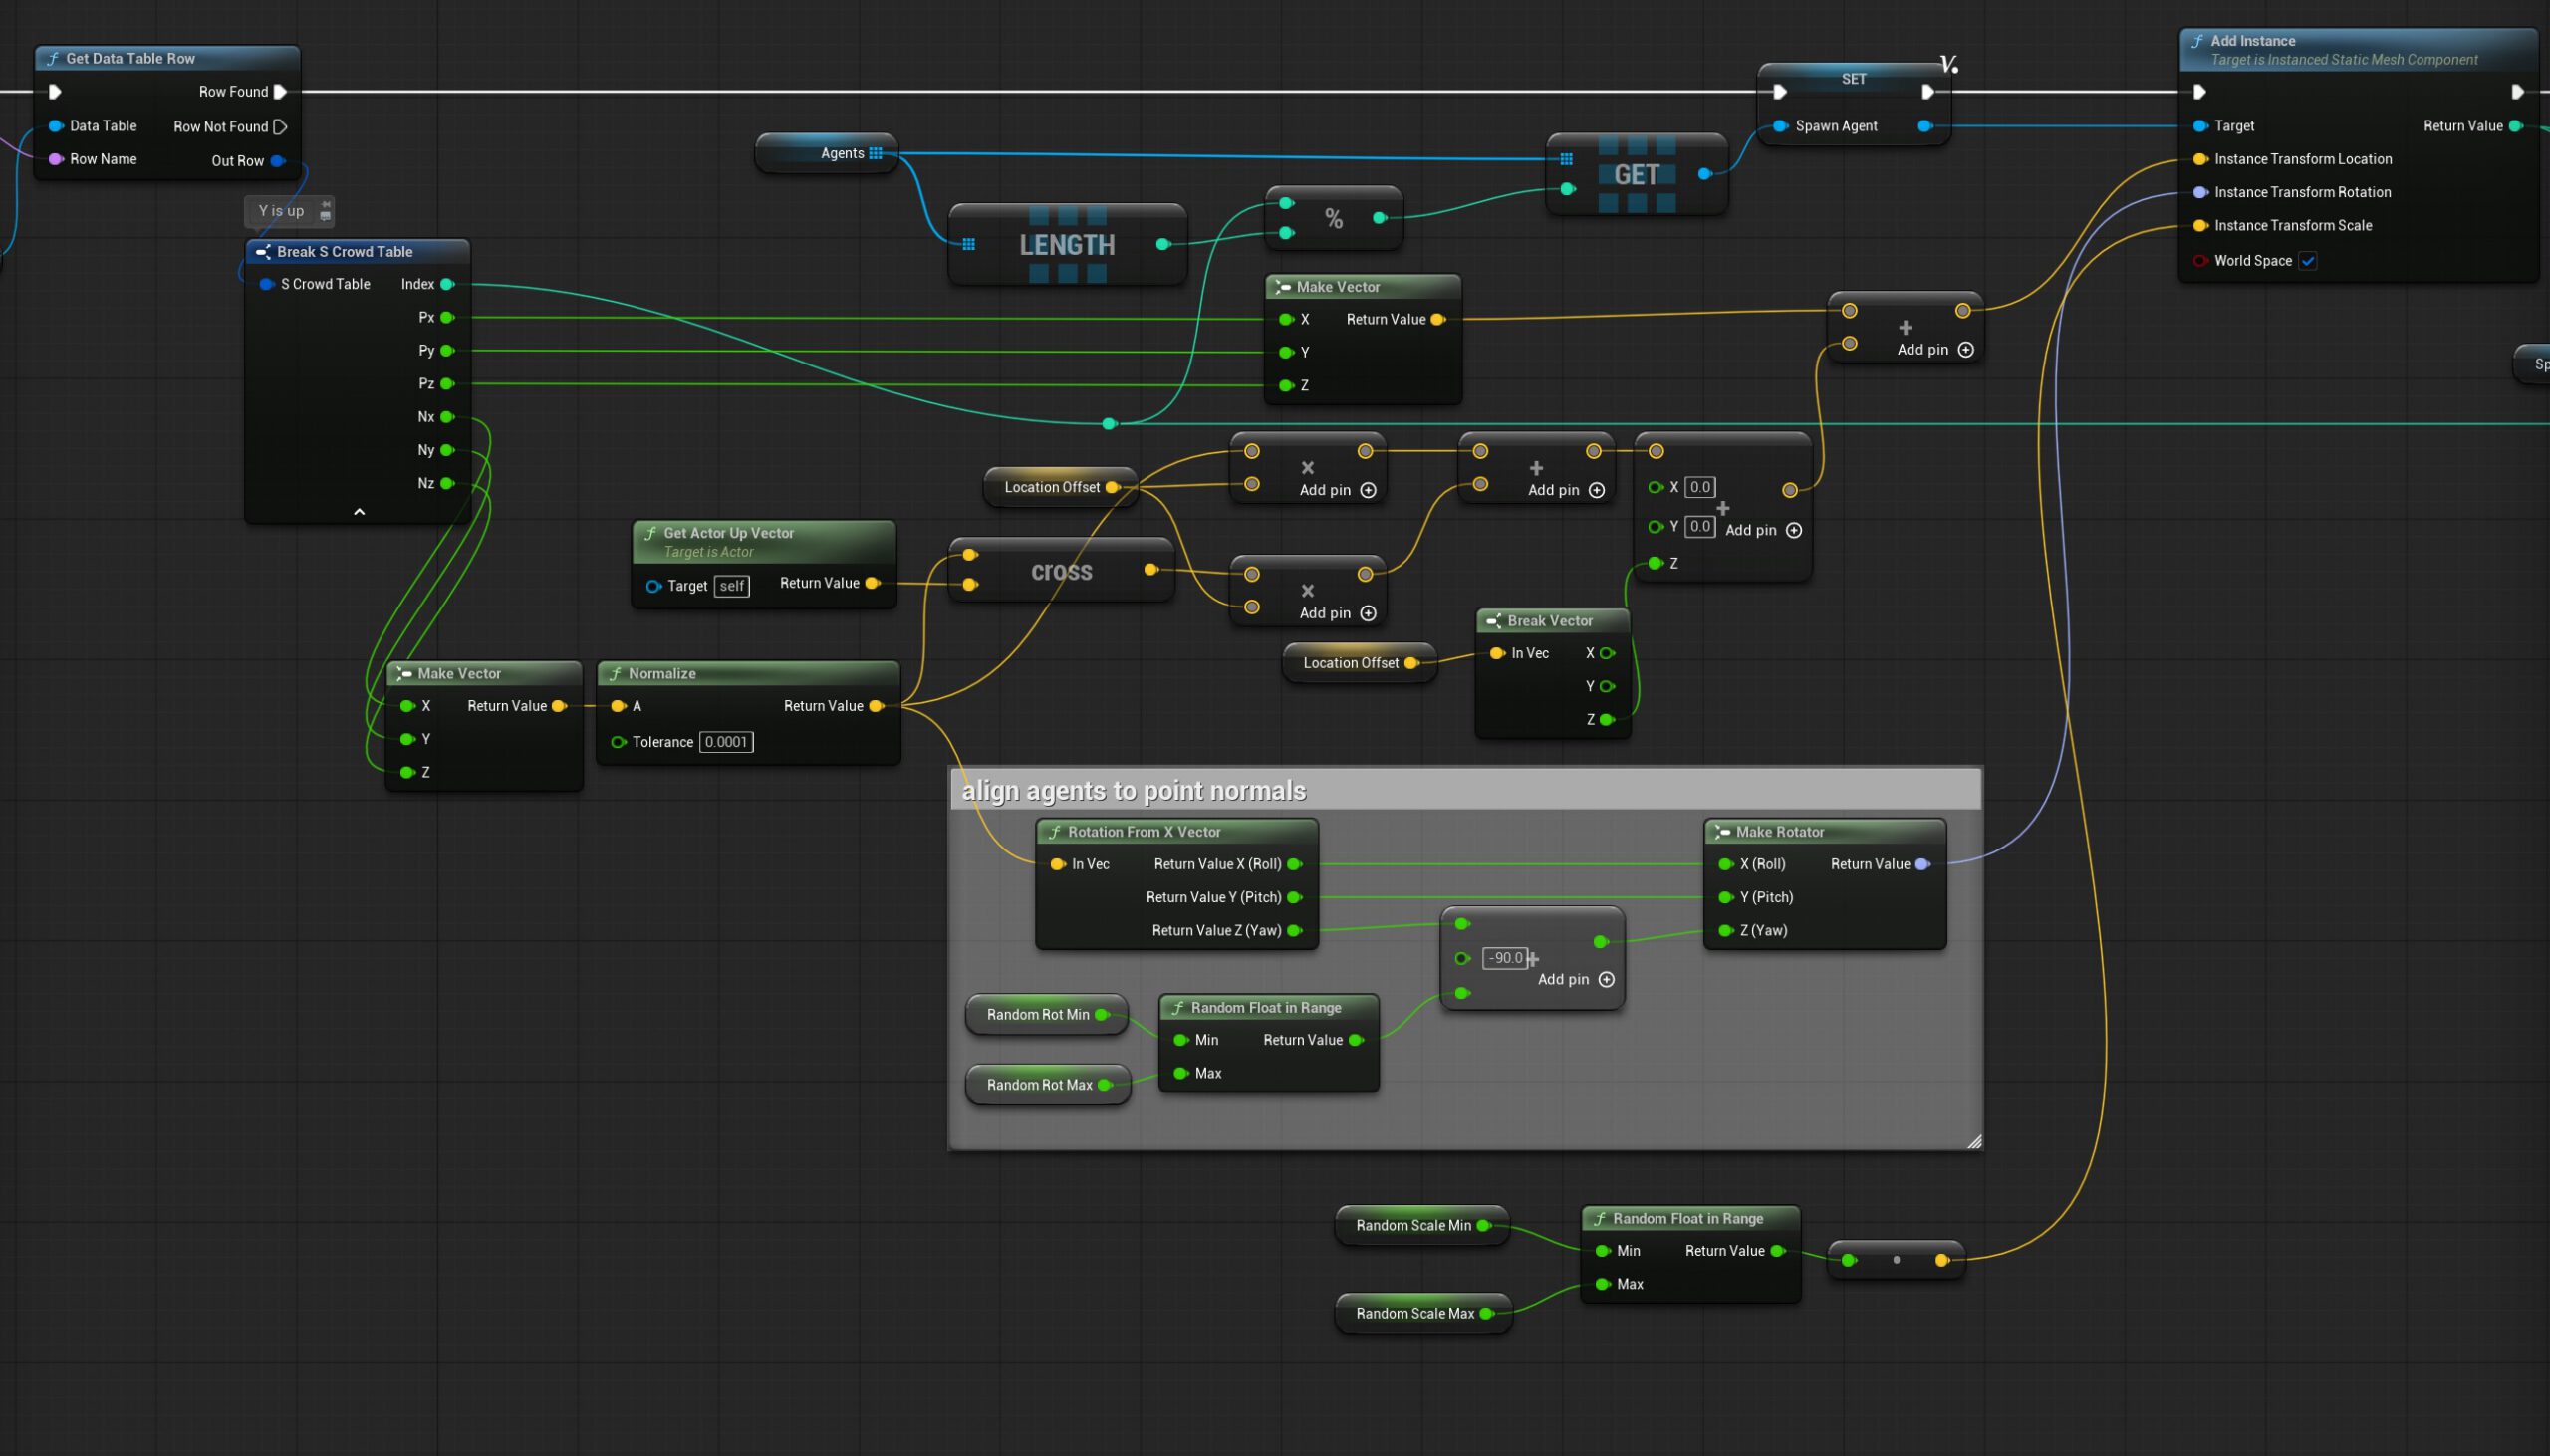
单个BP_CrowdManagerActor 读取数据表并填充 HISM。生成函数(AddAgentInstances)接受目标代理数量,根据当前状态计算要添加或移除的实例数,并遍历(打乱后的)生成列表。
“打乱的生成列表”是实现有机填充的关键。数据表行不是在初始化时按行填充座位,而是按打乱的顺序排序。随着填充百分比滑块的增加,人群以随机、分散的图案遍布整个体育场。
UI 绑定
UI 控件使用两种类型的滑块:Spawn # 滑块直接控制总代理数量,Fill % 滑块控制已生成代理中可见的百分比。动画状态滑块(Clap、Yell、Stand)驱动 PerInstanceCustomData 通道以实现混合 alpha。
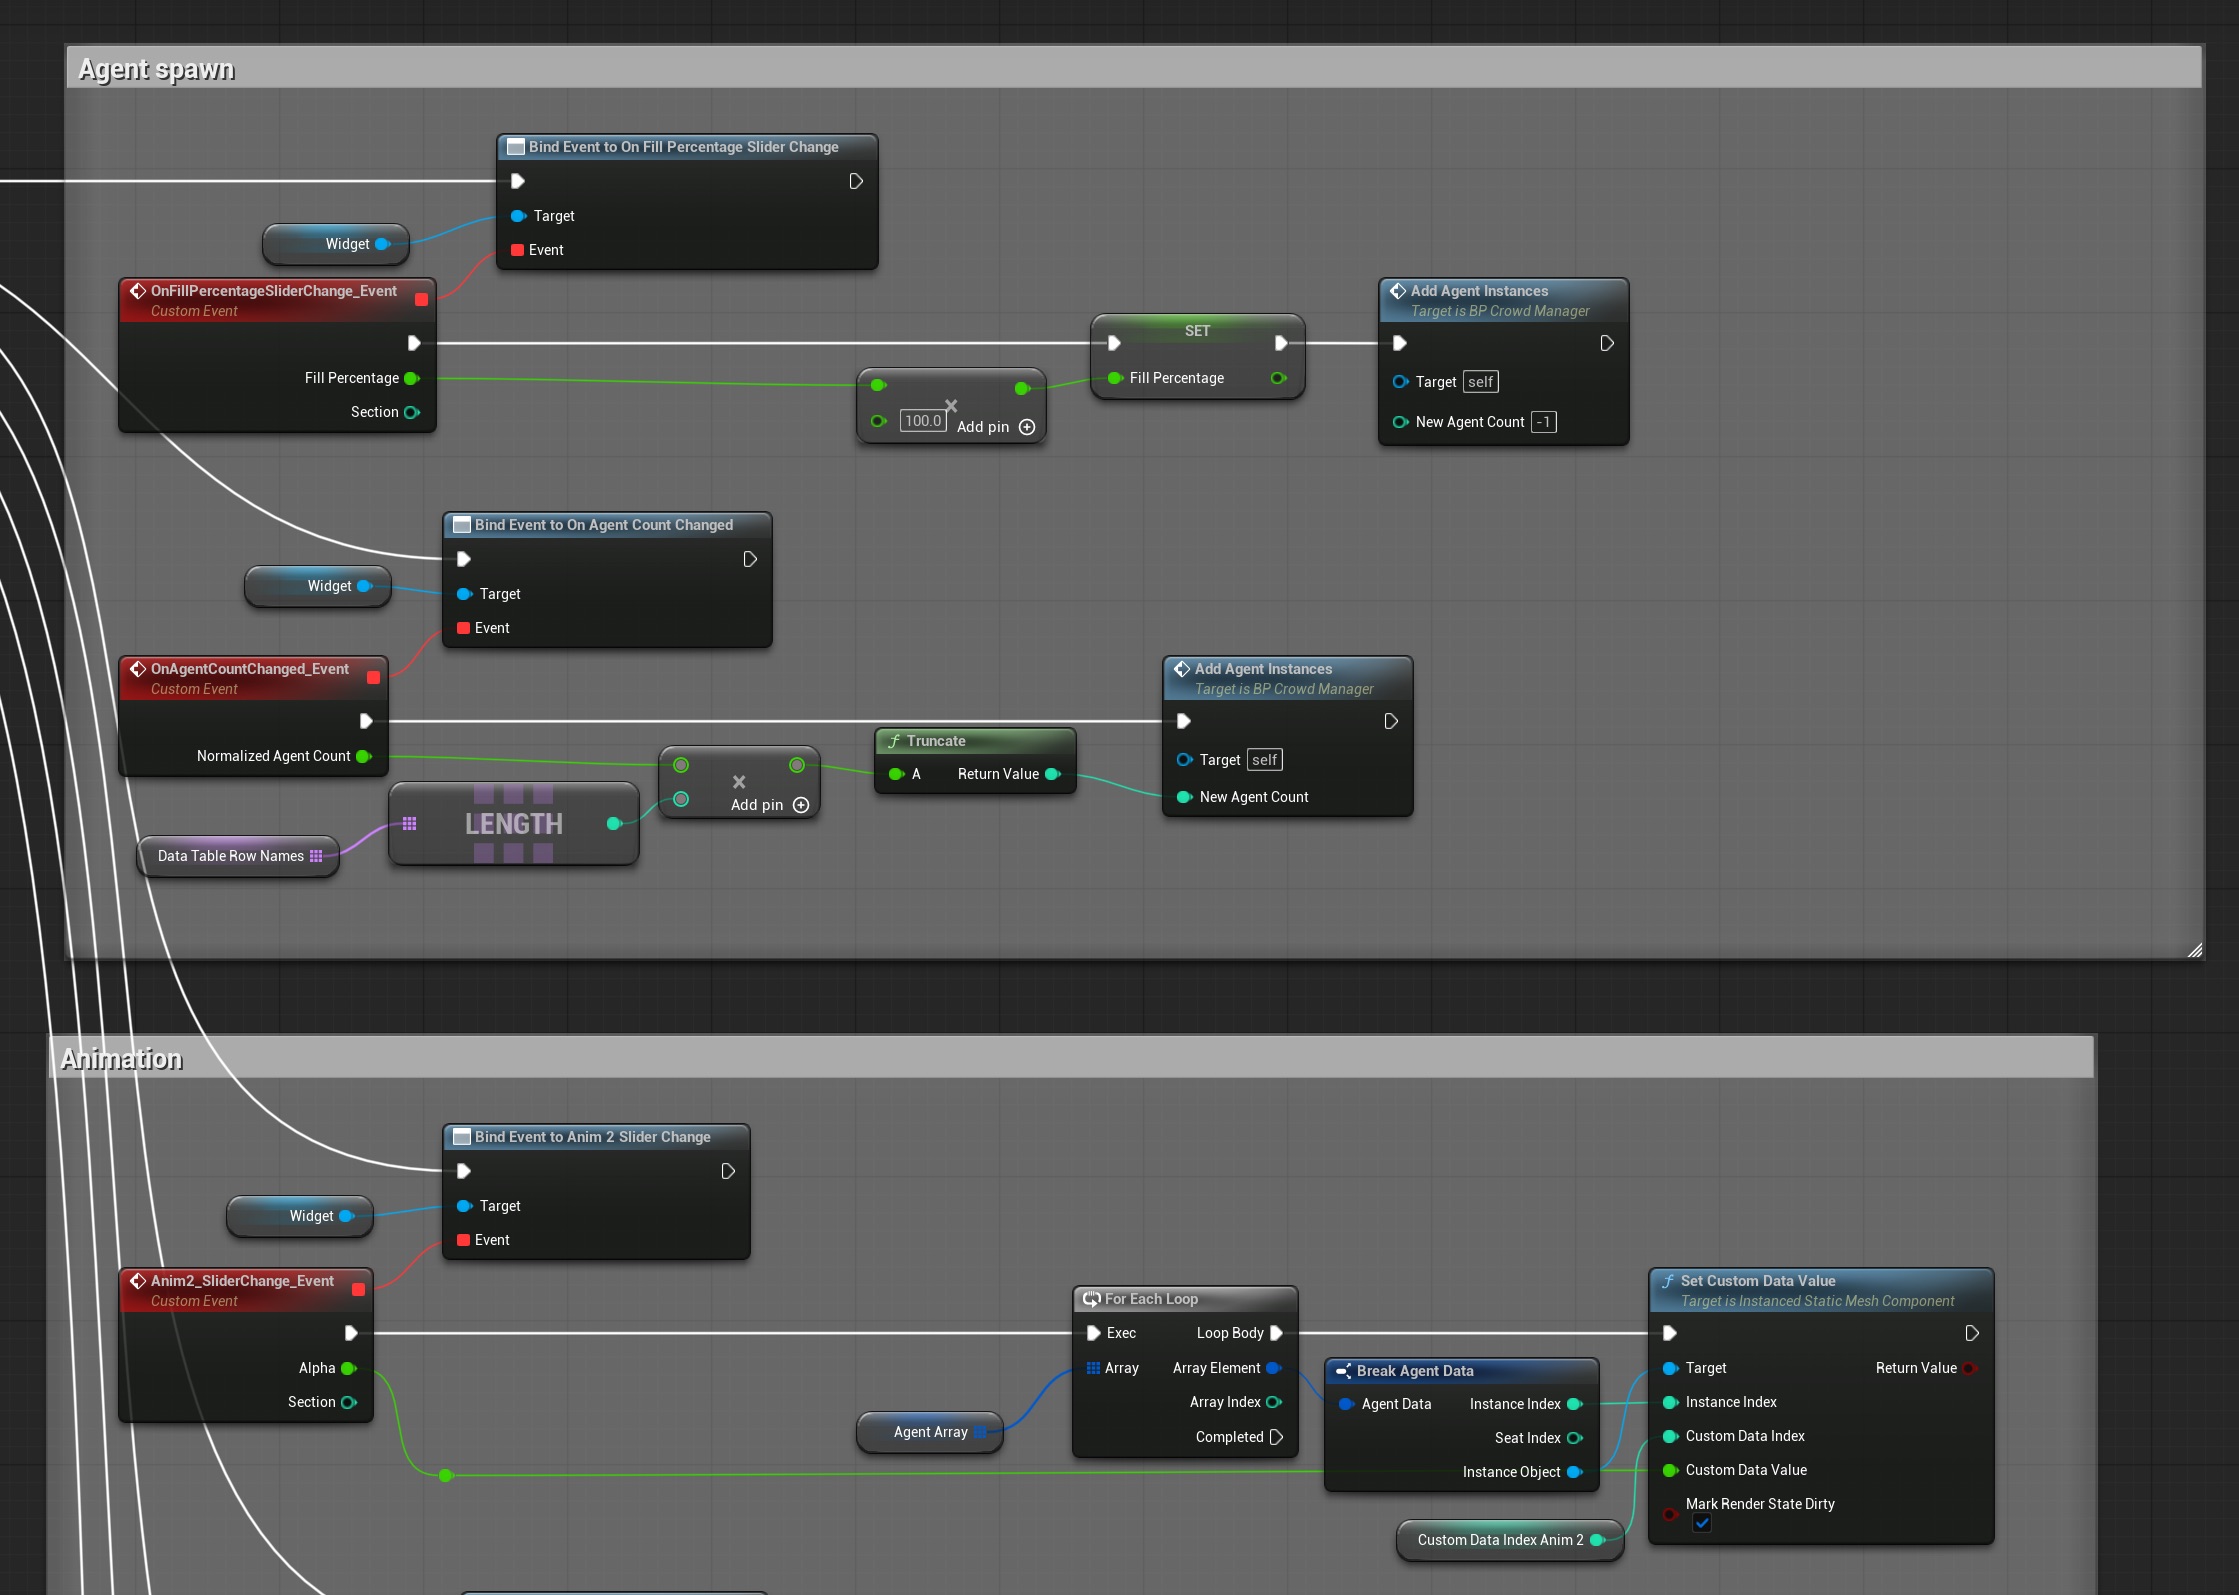
UI 绑定部分。上方:代理生成事件绑定到填充百分比和代理数量滑块,每个事件调用 AddAgentInstances。下方:动画滑块事件遍历所有代理实例并设置相应的自定义数据通道。
第 5 部分:性能结果
实际运行演示
在数据之前:以下是系统在实际运行时的表现。
人群系统在实际运行中,支持实时生成和动画混合。当调整 Spawn # 和 Fill % 滑块时,观众会自然地分布在体育场内,而不是逐行填充。 动画滑块驱动每个实例的 PerInstanceCustomData 通道,使 6,072 名观众在 Idle、Clap、Yell、Stand 和 Wave 状态间切换,且无 CPU 动画开销。
VAT vs. Skeletal Mesh:真实成本
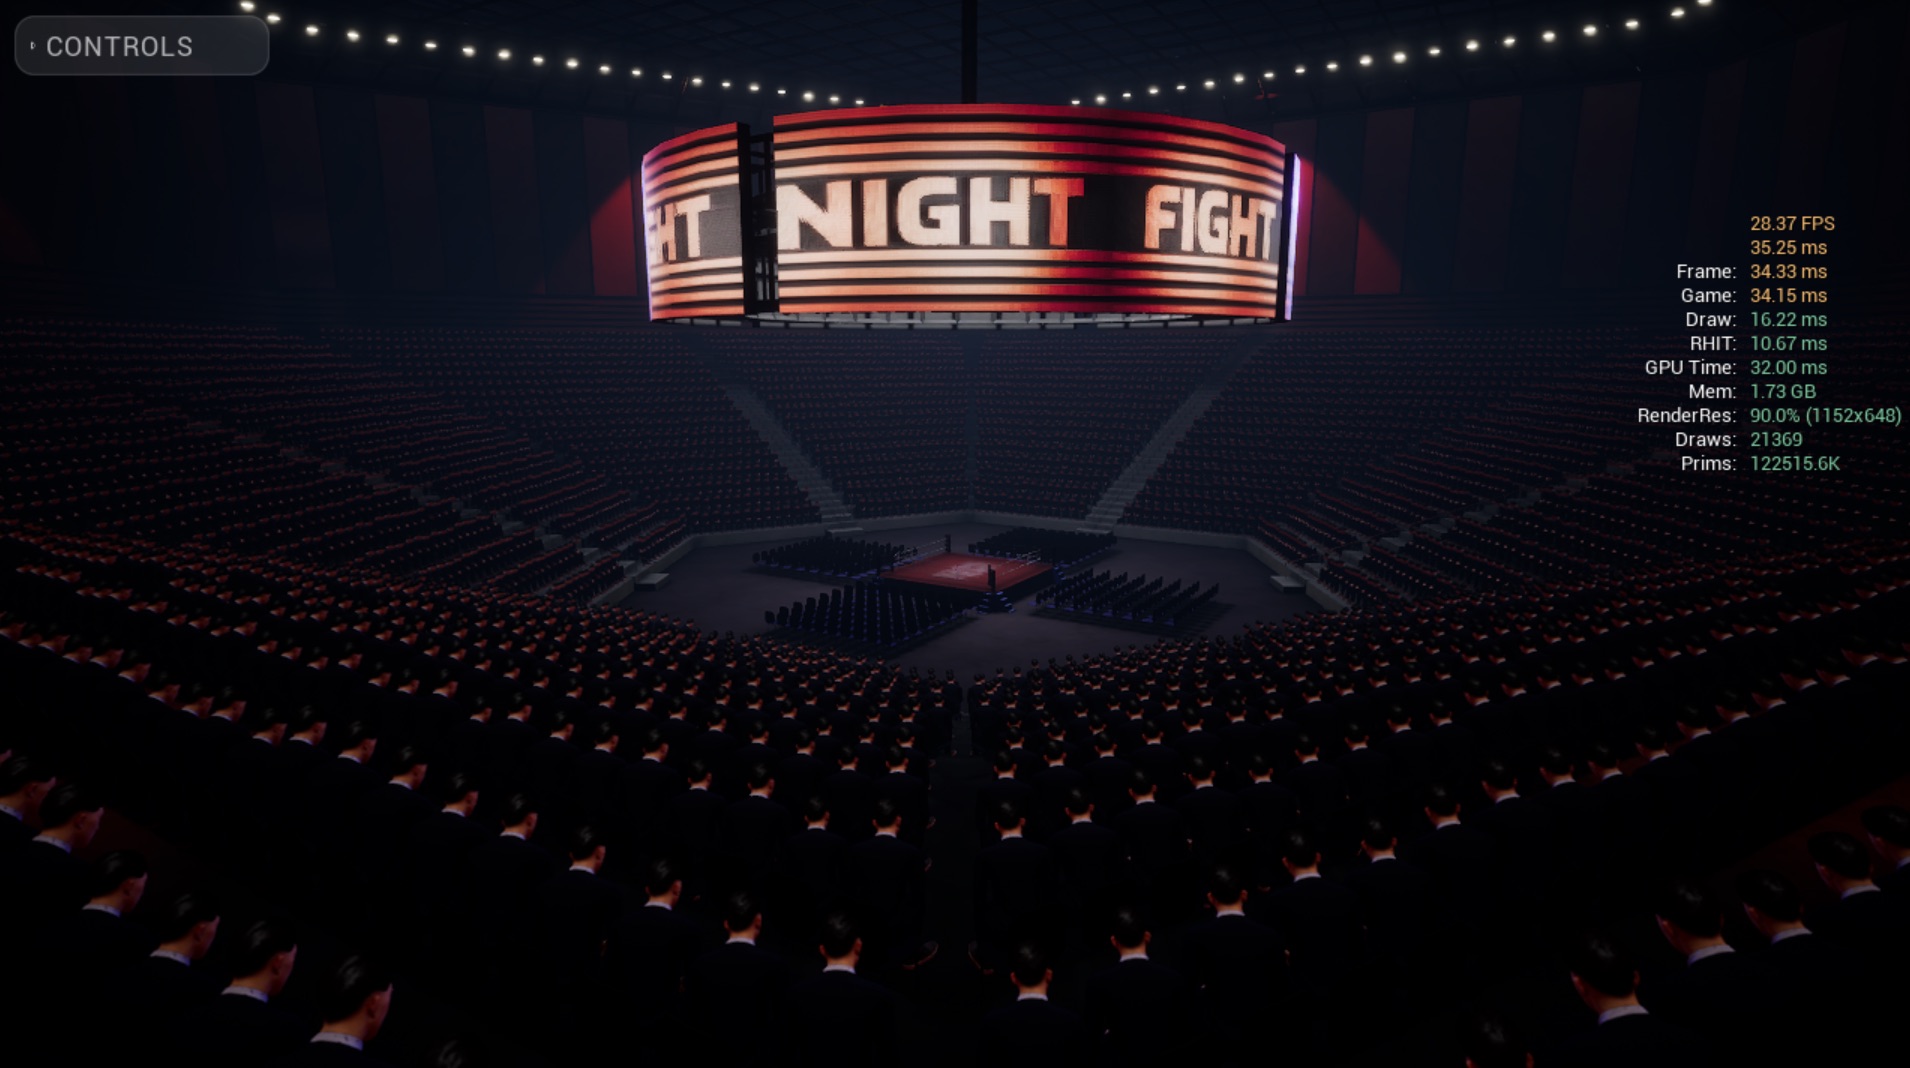
为了证明 VAT 方法的实际价值,同一个体育场使用了数量相当的标准 Skeletal Mesh Actor,并简化到与 VAT 静态网格体几乎相同的多边形预算,以确保比较的公平性。所有性能分析均在 RTX 3070、1080p、90% 屏幕百分比下进行。
两种方法的网格预算几乎相同。VAT 静态网格体为14,130 个三角形 / 10,063 个顶点,骨骼网格体为14,073 个三角形 / 12,292 个顶点。
|
指标 |
Skeletal Mesh(6,072 个代理) |
VAT + HISM(6,072 个代理) |
提升 |
|---|---|---|---|
|
FPS |
28.37 |
57.31 |
2 倍提升 |
|
Game Thread 时间 |
34.15 ms |
0.66 ms |
51.7 倍提升 |
|
Draw 时间 |
16.22 ms |
0.74 ms |
21.8 倍提升 |
|
GPU 时间 |
32.00 ms |
17.51 ms |
1.8 倍提升 |
|
Draw Calls |
21,369 |
276 |
减少 77.4 倍 |
消除 Game Thread 瓶颈:Game Thread 时间从 34.15 ms 降至 0.66 ms,这实际上“解锁”了引擎。CPU 之前忙于计算骨骼网格体的骨骼变换,几乎没有余力处理游戏逻辑、物理或其他游戏系统。
Draw Call 效率:将 Draw Call 从 21,369 减少到仅 276,RHI 开销降低了98.7%。通过将 6,072 个代理合并到分层实例静态网格体(HISM)中,引擎只需向 GPU 发送少量大型指令,而不是数千个小指令。
实例化带来的 GPU 收益:尽管顶点动画纹理在顶点着色器中增加了数学计算,但 GPU 时间几乎减半(32 ms 降至 17.5 ms)。这证明管理 6,000 个独立骨骼网格体 Draw Call 的开销实际也在拖慢 GPU 本身,而 HISM 实例化管线对于硬件处理来说效率更高。
Shader 复杂度
Unreal 的 Shader Complexity 视图会根据每个像素的指令开销从绿色(低开销)到粉色(高开销)进行颜色编码。当帧中填充了 6,072 个 VAT Agent 时,整个群体始终渲染在绿色波段内。
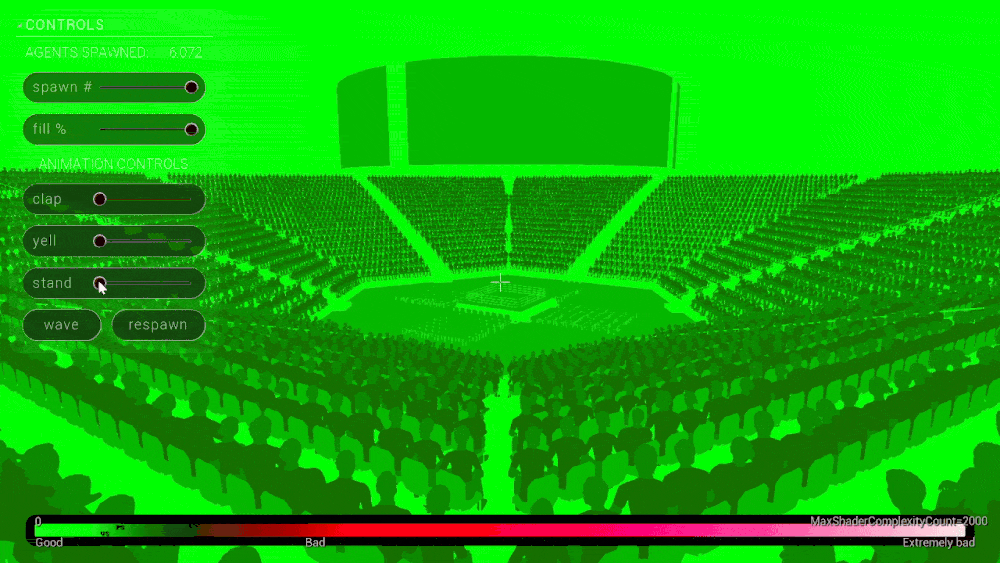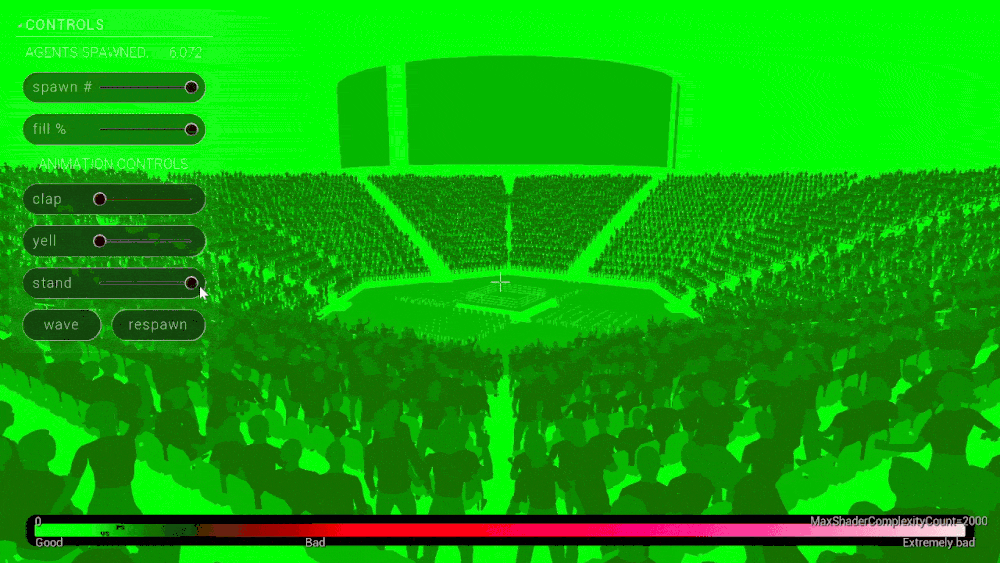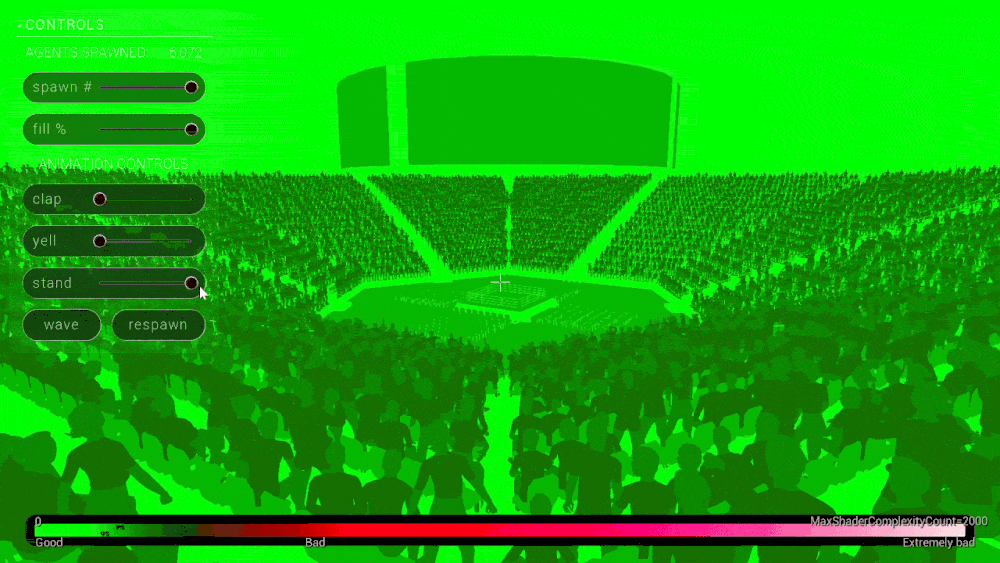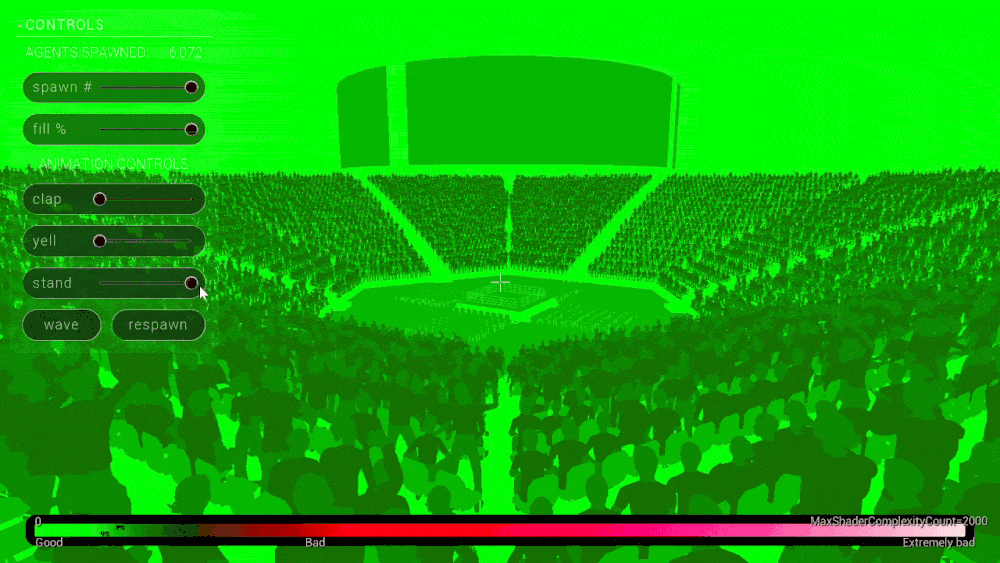
6,072 个活动 Agent 的 Shader Complexity 缓冲区可视化。尽管同时进行了五次动画纹理采样、包围盒解压缩、Lerp 混合、波浪时序以及每个实例的颜色变化,整个群体的复杂度在整个竞技场中始终稳定在“良好”的绿色范围。
8-bit 与 16-bit 纹理精度陷阱
在 Houdini VAT ROP 设置中有一个很容易被忽视的决定,却会产生非常明显的影响:Raster Depth。如果将其设置为 8-bit 而非 16-bit 浮点,则存储的位置偏移会产生量化误差,表现为顶点抖动。请始终使用 16-bit。纹理内存开销很小,但视觉差异非常明显。
结论
从 CPU 驱动的骨骼网格体转向 GPU 驱动的 VAT 实例,改变了群体系统的根本问题。它不再关注能负担多少个角色,而是如何让它们感觉真实。这个项目中最令人满意的时刻是第一次看到波浪在整个体育场中传播,6,072 个角色依次起立,仅由 CPU 发送的两个数字驱动,别无他物。这正是技术美术的承诺:将冰冷的数学转化为集体的情感。
展望未来,这个系统的潜力远不止于手动滑块。通过将动态灯光反应集成到着色器中(体育场灯光根据群体能量脉动),并通过共享材质的 VAT 网格体扩展角色多样性,它可以走向不仅密集而且深度反应的环境。这个框架为由实时、不可预测的游戏事件驱动的群体铺平了道路,将背景观众转变为数字体验的积极参与者。
在视觉复杂性日益增长的时代,最强大的优化不仅仅是节省帧率。而是为生命留出空间。


喜欢这篇内容吗?