
ABCD:以恒定显存训练大规模高斯泼溅场景
摄影测量与神经渲染技术使得重建越来越庞大的真实世界环境成为可能,但这些场景的规模很快就会超出即便高性能 GPU 的可用显存。对于研究科学家 Ka Heng Shiu来说,这在他参与 The Lost Metropolis 项目时成为了一个实际障碍——这是一个艺术与遗产项目,致力于归档香港正在消失的城市空间。
Shiu 的扫描涵盖了整座村庄,以及内部和外部都完整的建筑。当他尝试使用 3D Gaussian Splatting 重建这些环境时,他反复遇到 GPU 显存不足的问题。这个问题最终促成了 ABCD: Alpha-Composited Block Coordinate Descent,这是一个与 Kartic Subr 共同开发的 out-of-core 训练框架,最近在 SIGGRAPH 上展示。
ABCD 将场景划分为多个空间分区,并一次只优化一个分区。与先训练若干相互隔离的区域再将其合并的方法不同,ABCD 通过缓存的前景和背景 RGBA 图像,让场景的其余部分在视觉上保持存在。这使得活跃区域能够在完整环境的上下文中接受训练,同时让峰值显存占用实际上与场景的总规模无关。我们与 Shiu 聊了 ABCD 的工作原理、它目前在内存和训练时间上的权衡,以及它在城市级采集、游戏开发、数字孪生和分布式渲染工作流中的潜在应用。
首先,能否请你介绍一下你自己、你的研究以及你的背景,作为开场?
Ka Heng Shiu,研究科学家: 嗨,我是 Heng!我是一名研究科学家,拥有神经图形学背景,尽管我尽量不把自己局限在一个框架内。我也曾从事生成式 3D 和 LLMs 的工作,并且我通常喜欢把理论上有趣的想法,找到它们能派上用场的实际问题。
ABCD 就是一个很好的例子。它实际上始于一个名为 The Lost Metropolis 的艺术与遗产项目,当时我正在归档香港正在消失的城市空间。我当时正在对非常大的环境进行摄影测量扫描,包括整座村庄以及带有内部和外部的建筑。然后我探索了这些扫描能否重建为高斯 splats。
问题很简单:我总是耗尽 GPU 内存。
我开始研究绕过这一限制的方法,最终把这个问题变成了我的学士学位论文,然后在我忙于找工作的那大约一年半里,把这个项目搁置了。后来我又回到这个项目,进一步发展了这个想法,并最近在 SIGGRAPH 上发表了由此产生的工作。
你能用通俗的方式解释一下 ABCD 的块坐标下降(block coordinate descent)方法吗?一次训练一个空间分区,与分别独立训练多个较小的场景然后再合并,有什么不同?
Ka Heng Shiu:对于一个大到 GPU 显存装不下的场景,最直接的做法就是把它划分成更小的区域,分别训练每一个区域,然后再把它们合并起来。问题在于,每个区域在优化时都不知道场景其余部分是什么样子。
想象把一个房间分成左半边和右半边。当你训练左半边时,一些相机图像中仍然包含右半边的物体。如果优化器只能使用来自左半边的高斯,它可能会为了让这些高斯解释它在图像另一侧看到的内容而错误地放置它们。当独立训练的两半被合并时,这些错误就会表现为悬浮的几何体、接缝或其他不一致。
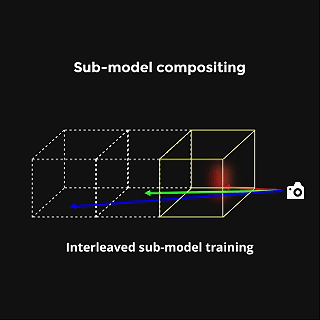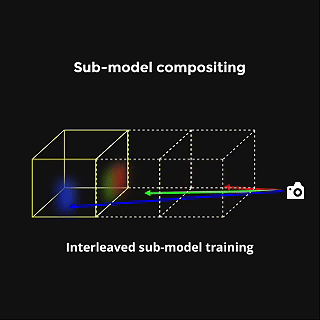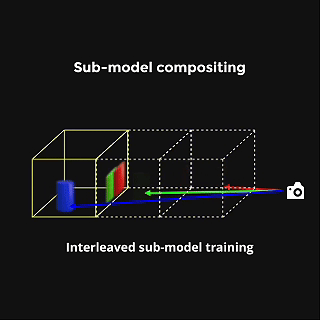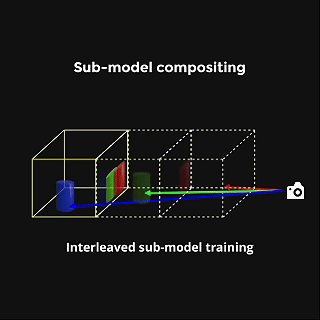
ABCD 的做法则不同:它一次只训练一个空间分块,同时让场景的其余部分保持可见但被冻结。
对于每个相机,非活动的高斯会被预渲染成一张前景图和一张背景图。活动分块则被渲染在这两层之间,然后三者通过 alpha 合成混合在一起。
关键在于,只有活动分块需要留在 GPU 显存中。场景的其余部分实际上已被压缩成图像,而这些图像的大小并不取决于它们代表了多少个高斯。
这让我们能够以受显存限制的分块为单位,一次优化一个非常庞大的场景,而无需把这些分块当作完全独立的场景来处理。
一项核心创新是将场景中不活跃的部分折叠为前景和背景 RGBA 图像。Alpha 合成如何让活跃分区在完整场景的上下文中得到优化,同时避免分区训练中常见的接缝和一致性错误?
Ka Heng Shiu:关键思路是,把某个东西从 GPU 显存中移除,并不意味着把它从渲染图像中移除。
场景中不活跃的部分被冻结,但它们通过预渲染的前景层和背景层仍然在视觉上存在。当活跃高斯点在这两层之间被渲染时,最终图像仍然呈现的是完整场景。
因此,优化器并不是在孤立地学习某个区块。它仍然能看到该区块应当如何遮挡、如何与周围几何体混合,以及是位于周围几何体的后面还是前面。
正是这种上下文避免了独立训练的分区所带来的许多不一致。ABCD 不是事后再把若干个分别优化的场景拼接起来,而是在整个训练过程中保持它们之间的关系。
ABCD 大幅降低了 GPU 驻留,但目前会增加系统内存占用和训练时间。你如何评估这种权衡?有哪些优化可以让系统更快,并减少对大量预渲染图像缓存的依赖?
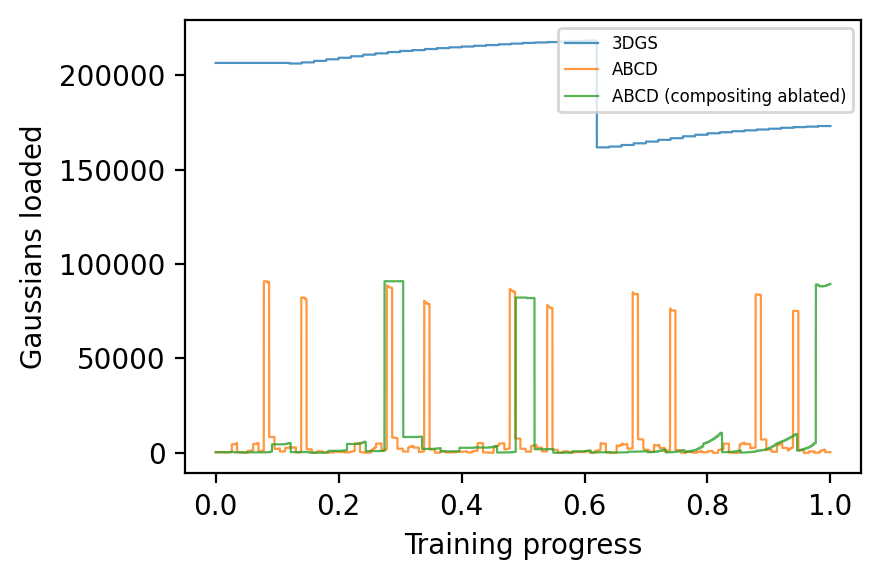
Ka Heng Shiu:当前的实现本质上是把稀缺的 GPU 显存换成更廉价的资源:系统内存、磁盘存储以及额外的训练时间。
显存主要由活跃区块的大小和渲染分辨率决定。内存用于缓存那些可能观察到该区块的相机所对应的图像,而磁盘则存储更大规模的预渲染相机与区块组合。
随着整体场景变得更大,重要的特性是峰值显存不必随之增长。你可以让活跃区块保持固定大小。
其他成本仍有很大的改进空间。我们目前的可见性测试相当保守。它只检查某个区块是否位于相机的视锥体内,而不检查该区块是否实际上被其他几何体遮挡。考虑遮挡的剔除可以消除许多不必要的缓存视图。
这在超大型环境中尤其有意思。可见性往往是局部的。站在一条街上的相机看不到一座城市的大部分。如果我们能很好地利用这一特性,内存占用就有可能更接近一个局部工作集,而不是随场景总规模增长。
目前缓存还使用无损 PNG 存储。更激进的图像压缩、更好的缓存策略,以及减少分区需要刷新的频率,都有可能大幅降低存储和训练开销。这些都是很有前景的方向,不过我们还没有对它们进行评估。
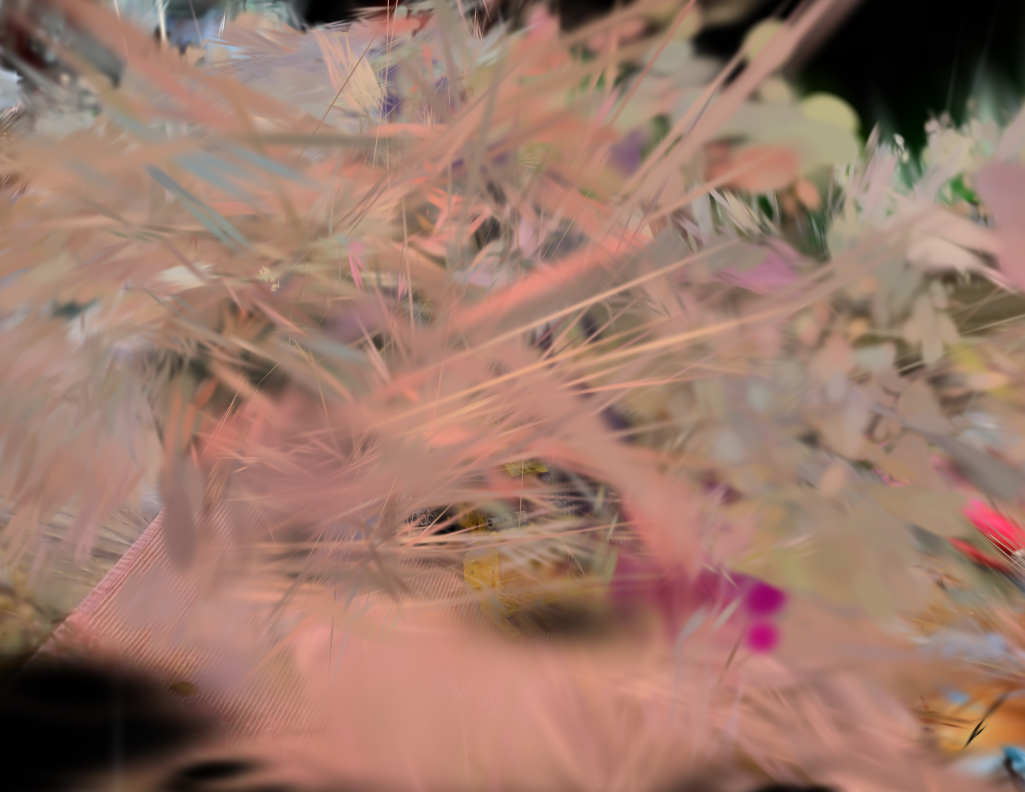
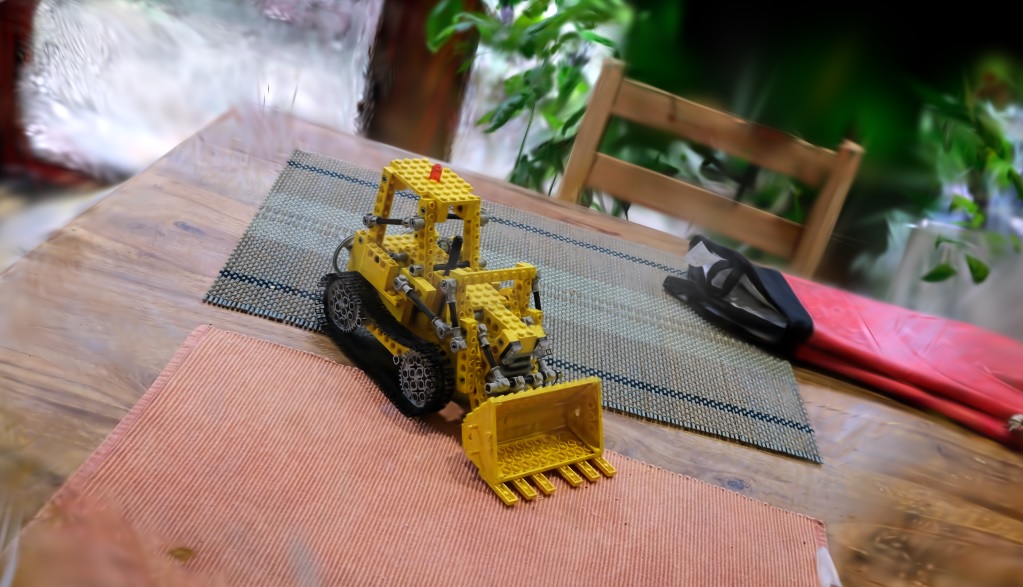
你目前的实验使用的是相对较小的场景,其中固定开销在一定程度上掩盖了该方法预期的内存优势。什么规模的现实世界数据集最能展示 ABCD 的潜力,而在转向城市尺度或类似大规模采集时,你预计会出现哪些新问题?
Ka Heng Shiu: 在真正城市尺度的数据集上测试 ABCD,会使其内存扩展优势在视觉上明显得多,而这最终正是该方法被提出时所针对的那类问题。
与此同时,论文中的实验刻意采用了另一种压力测试。Mip-NeRF 360 的场景相对紧凑,但很难干净地划分。我们把一些场景拆分成将近 30 个空间块,这产生了许多分区出错的机会。
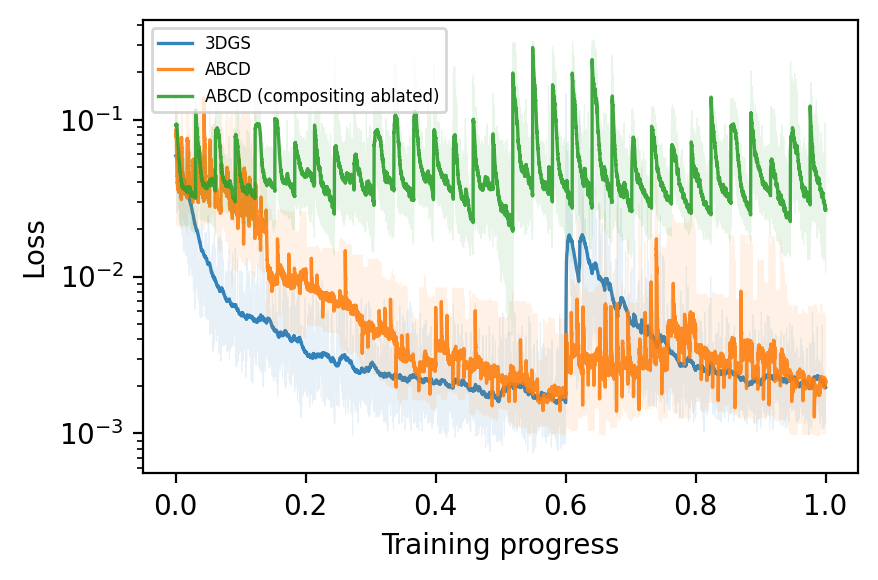
尽管如此,最终重建结果几乎没有显示出可见的分区伪影,并且收敛情况与基线高斯泼溅模型相似。
该方法在更小的尺度上也已经有用。如果一个场景仅略微超出 GPU 的内存容量,仅将其分成两块,就能大致将高斯相关的 VRAM 需求减半。
对于城市街区尺度的重建,我预计更大的挑战将变成计算,而不是 VRAM。随着分区数量增长,在它们之间反复切换、更新缓存上下文以及重新访问各个块,会变得越来越昂贵。
因此,在非常大的尺度上,核心问题就从“我们如何把这个模型放进内存?”转变为“我们如何高效地调度和更新所有这些局部区域?”
尽管当前的实现针对的是 3D Gaussian Splatting,但你把 ABCD 描述为一个更广泛的、面向 alpha 合成辐射场的框架。它最终能否支持其他表示方式、分布式训练,或者用于扫描大型游戏环境、数字孪生和虚拟制片场景的生产工作流?
Ka Heng Shiu:是的。ABCD 的核心思想本质上并不与 3D Gaussian Splatting 绑定。
它需要的是一种能够进行空间划分、并且其贡献可以通过 alpha 合成重新组合的表示方式。原则上,这可能包括类 NeRF 表示、基于三角形的 splatting,或其他辐射场方法。
我觉得一个特别有趣的方向是分布式训练。
当前的实现使用一块 GPU,按顺序依次处理各个分块,但从概念上讲,不同的分块可以由不同的工作节点来优化。由于每个工作节点大部分时间都在本地针对某一个区域工作,系统可能不需要像紧耦合分布式训练那样持续进行高带宽同步。
这可能让异构硬件变得特别有用。你不必再要求一个由相同高端 GPU 组成的集群,而是可以设想根据不同机器上可用的显存和算力来分配分块。
在更大规模上,这暗示了一种可以动态添加或移除工作节点的模式,并且可能混合使用本地机器和云实例。
这仍然是一个未来的研究方向,而不是当前实现所展示的能力,但我认为,把大场景重建视为一系列相互协调的局部优化问题、而不是一个单体模型,这是由此带来的最令人兴奋的结果之一。
与其问“能装下这个场景的最大 GPU 是什么?”,更长期的问题变成了:“我们如何利用一切可用的算力来共同训练这个场景?”
徐嘉亨(Ka Heng Shiu),计算机图形研究科学家
你可以在完整的研究论文中了解更多关于这项工作的内容,或者亲自查看GitHub 上的代码。
相关链接
- Research Scientist Ka Heng Shiu
- presented at SIGGRAPH
- full
- code on GitHub
- ABCD: Alpha-Composited Block Coordinate Descent
原文链接:https://80.lv/articles/how-abcd-trains-large-gaussian-splat-scenes-with-constant-vram


喜欢这篇内容吗?