
Arc Raiders 敌人 AI 幕后:用机器人学与强化学习做物理驱动行为
Arc Raiders 是近年来最受瞩目的爆款作品之一,而今天推出的全新 Flashpoint 更新有望让它更上一层楼。而且与市场上最大的那些大作相比,它的制作预算比你最初想象的要小。
无需专业眼光,哪怕只是粗略一看,也能发现《Arc Raiders》中的敌人与传统游戏 AI 有着本质区别。它们不会遵循僵化的模式或脚本化行为,而是对环境做出动态反应,从干扰中恢复过来,有时甚至会出现在连开发者都未曾预料到的地方。这种不可预测感不仅是一种设计选择,更是多年来对机器人技术、物理模拟和机器学习研究的结果。
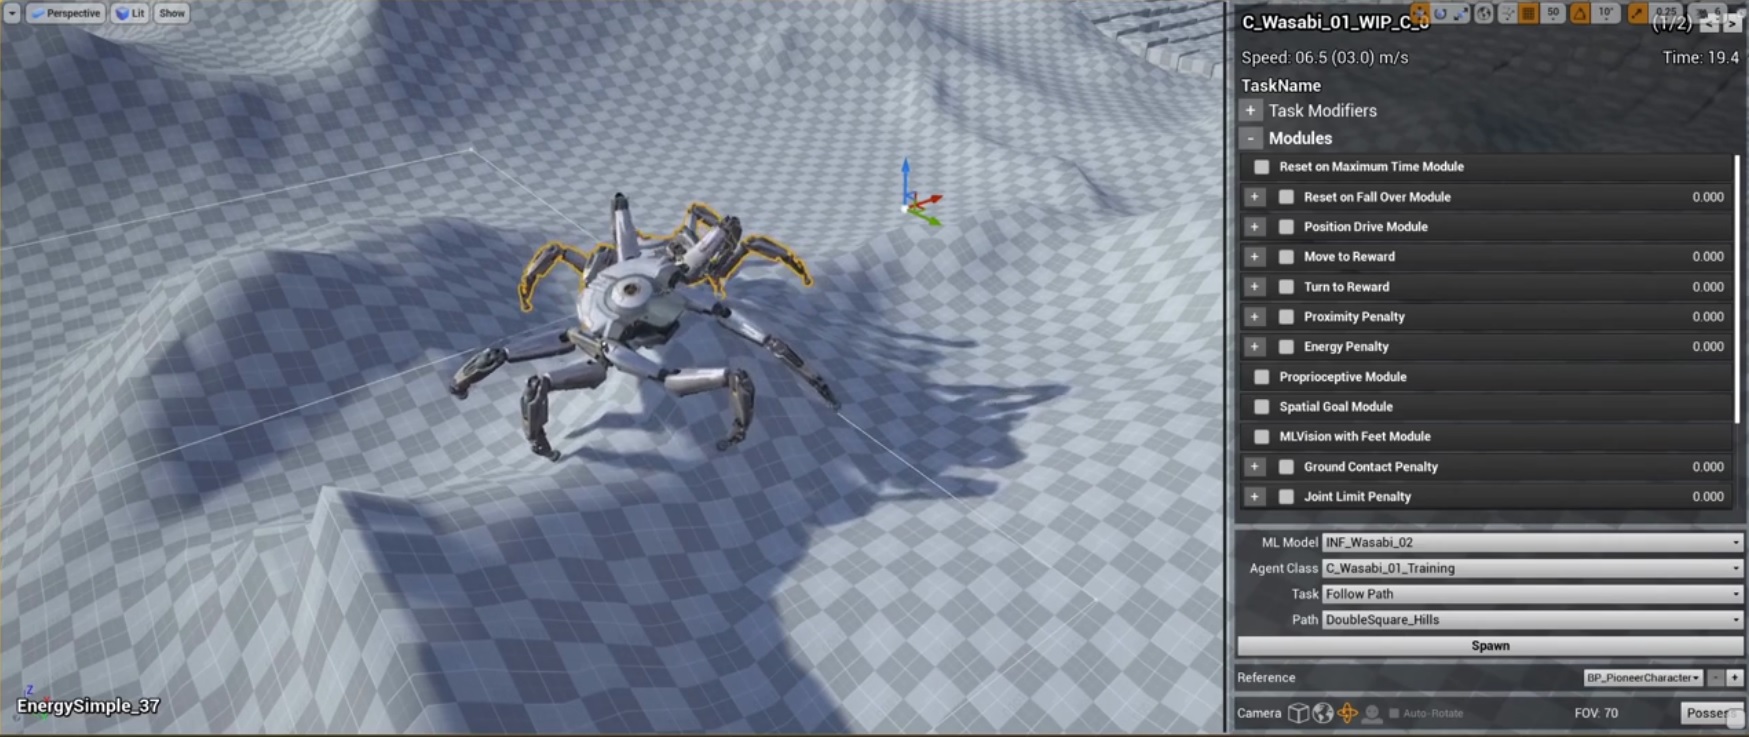
在 Embark Studios,团队以系统优先的视角来处理敌人设计,不再把敌人当作动画角色,而是更像必须在动态世界中导航并生存的物理实体。这一决定直接将他们引向机器人研究和强化学习,借鉴控制现实世界机器的技术,并将其适配到游戏环境中。
《Arc Raiders》并未完全依赖传统 AI 系统,而是将学习得到的运动能力与行为树相结合,创造出一种分层方法,让移动本身成为智能的一部分。
我们采访了Martin Singh-Blom,Embark Studios 机器学习研究负责人,探讨了这些系统如何运作、将它们投入生产所面临的挑战,以及为什么物理驱动的 AI 会从根本上改变玩家与敌人的互动方式。以下是对这次面对面采访的轻度编辑文字记录。
你能介绍一下自己,并概括一下你在 GDC 上演讲的重点吗?
Martin Singh-Blom:我叫 Martin Singh-Blom。我大约在 2019 年 1 月或 2 月加入,所以是在工作室成立仅几个月后。
演讲的大致要点是,物理是《Arc Raiders》中非常重要的一部分。当你射击无人机或敌人时,它们会做出正确的反应,而许多玩法都来自涌现式交互。例如,你可能把敌人射向墙壁,它因为撞墙而受到额外伤害并爆炸,而不是因为你的霰弹枪。
我们很早就知道,我们想要那样的涌现式玩法,因为它带来很高的可重玩性。我们也知道自己想要有腿的敌人,也就是大型机器人,它们能四处行走,并与世界进行物理交互。
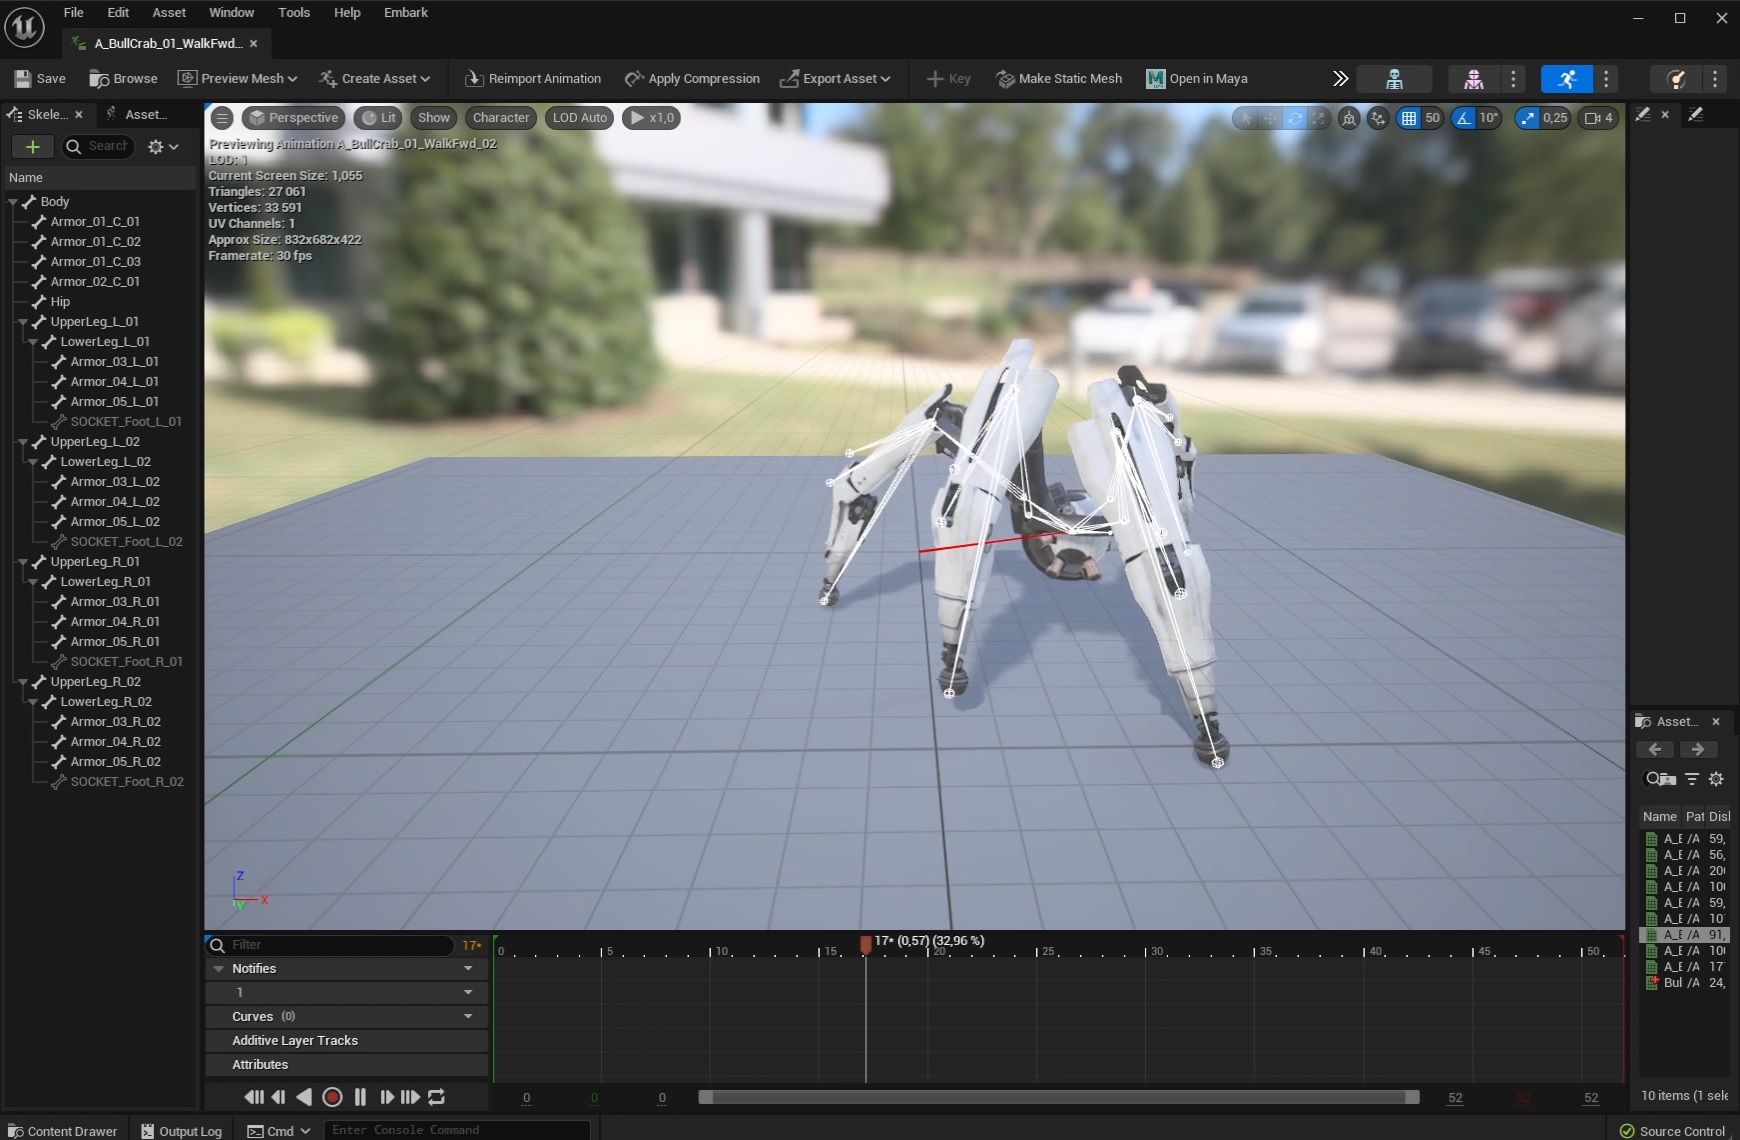
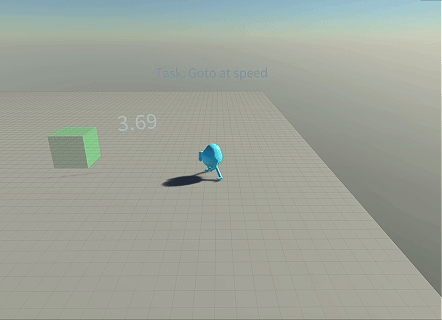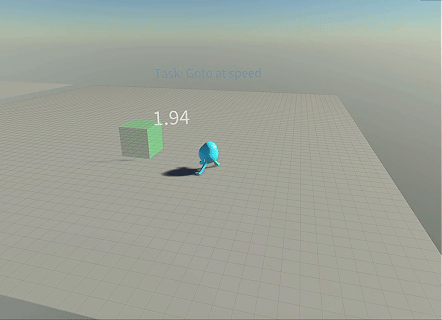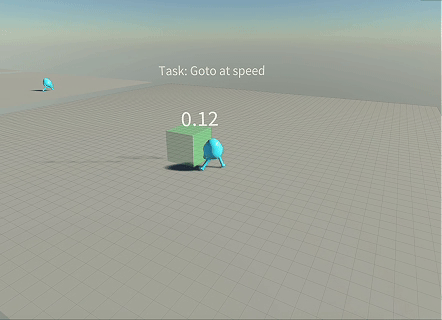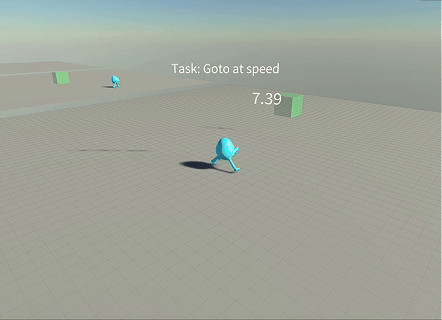
如果你想拥有这些,就会遇到和机器人学相同的问题。即使你的机器人是模拟的,它仍然是一个需要移动和保持平衡的物理机器人。因此,我们不得不深入研究机器人学文献,采用他们控制真实机器人的方法,把它放进我们的游戏,并让它为我们所用。
演讲的很大一部分内容是关于我们遇到了哪些问题,哪些地方与机器人学相同,哪些地方不同。例如,机器人可以使用摄像头,但我们不能这样做,因为那需要在服务器上渲染,成本太高。与此同时,我们可以作弊——真实机器人不能在开始坠落时获得把它们托起来的魔法力,但我们可以。
然后其中很大一部分是强化学习,这是一种人们用于机器人学的深度学习方法。所以演讲的一部分是介绍它,另一部分是关于在游戏中应用它所带来的挑战。”
与传统 AI 相比,是什么让《Arc Raiders》的敌人感觉如此不同?
Martin Singh-Blom:我认为并非所有这些都直接来自机器人技术方面的工作,但几乎一切都源于“让一切皆具物理性”这一决定。
在传统动画系统中,你始终知道敌人会在哪里。没有任何灵活性。如果你撞到它,它不会有反应,因为它只是在播放动画。但既然我们决定采用物理系统,我们就不一定知道敌人会在哪里。如果你朝它扔东西,它可能会被撞离原本的路径,最后跑到别的地方。
这迫使我们把所有系统设计得更加灵活。许多其他游戏中那种严格的寻路在这里不再适用。
所以,玩家所感知到的“智能”,一部分是因为敌人在一个真实世界中行动,拥有与真实物体相同的自由度;另一部分是因为它们从一开始就被设计为能在那种环境中自我纠正和调整。
至于其余部分,说实话并没有看起来那么神奇。我们有一支非常强的 AI 团队,使用效用 AI 之类的方法,他们花了大量时间调整行为,使其感觉一致且具有惩罚性。
我们不是围绕固定模式来设计敌人。相反,我们会思考哪些原则引导敌人,以及为什么。这让它们感觉像是有意图的。它让游戏从记住模式转向理解行为。
为什么游戏不依赖传统的敌人行为模式或脚本化遭遇?
Martin Singh-Blom:由于物理机制,我们确实无法这样做。
我们尝试过构建更传统的行为系统,但一旦发生意外情况,比如敌人被推动,这些模式就会失效。
这一切都归结于物理。物理增加了一层不可预测性,并渗透到设计的根本之中。因此我们不得不彻底放弃那种方法。
机器学习如何融入整体 AI 系统?
Martin Singh-Blom:机器学习部分实际上比人们想象的要有限。它严格用于移动控制,比如机器人如何放置脚以及如何移动。这是一个非常困难的问题,传统方法对足式机器人效果不佳,因此我们不得不走向研究前沿,使用强化学习。
对于无人机,我们不需要这样做,因为我们可以使用传统控制系统,就像你在现实世界中的无人机上看到的那样。但对于足式机器人,我们还没有找到任何其他可行的办法。
一旦进入更高层级的决策,比如去哪里或做什么,这就由更传统的系统处理,比如行为树。
两者之间存在边界。例如,如果机器人前方有一个箱子,行为树可能决定它想向前移动,但移动系统决定如何到达那里,是从箱子上方越过还是绕过去。
随着模型改进,我们可以将更多决策交给机器学习一侧。这就是有趣的地方,因为机器人可以开始自己做决定,比如决定从狭窄空间挤过去或跳过某个物体,这为玩家创造了更多令人惊讶的情况。”
你能谈谈你见过的一些涌现行为和意外结果的例子吗?
Martin Singh-Blom: 我们见过敌人最终出现在我们完全没有预料到的地方的情况。
内部有一段视频,有人展示了一只跳跃者(leaper)在一个穹顶里,而我们甚至不知道它能进到那里。我们不知道它是怎么进去的。也许是爆炸把它推了进去,也许是它挤了进去;很难说。
但是当你有数百万玩家时,百万分之一的事情一直在发生。那些时刻对我们来说真的很有趣,因为它们表明系统正在产生我们没有明确设计过的行为。
网上有很多讨论,说这些敌人非常聪明、非常复杂,许多玩家猜测它们真的会随着时间推移适应玩家的习惯,从而学习和进化。这是真的吗?
Martin Singh-Blom:它们确实会让人觉得越来越聪明,并且会发展出新的战术,这一点完全属实,但背后的机制并不是人们所想的那样。
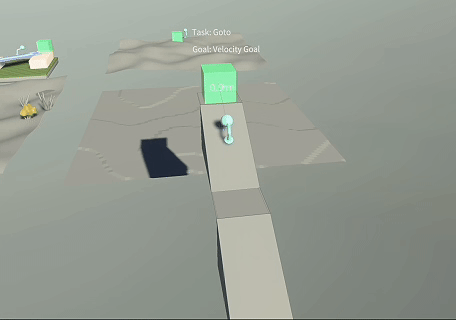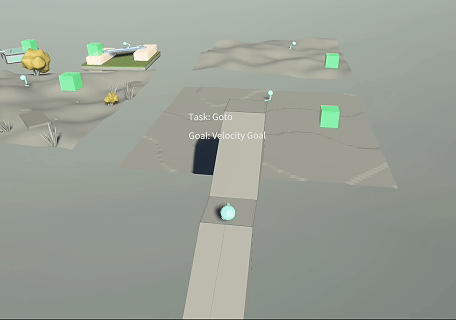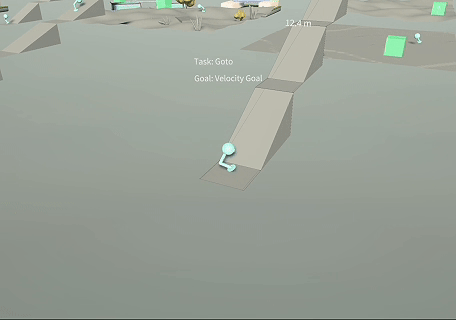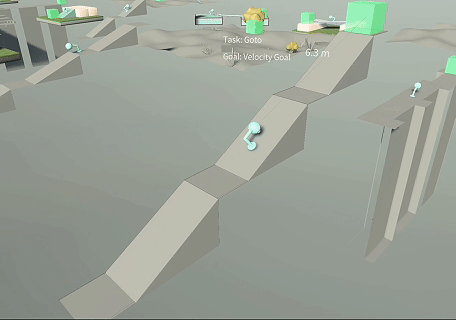
我们并没有做在线学习之类的事情。实际发生的情况是:我们看到一些有趣的行为,也许是在 YouTube 视频里看到的,然后我们决定想要更多这样的行为。
于是我们创建受控的训练场景来鼓励这种行为。我们不是在一个固定的设置上训练,而是把物体位置之类的因素随机化,让行为变得更加稳健。
如果我们只用真实游戏数据来训练,那么当关卡中发生变化时,行为就可能失效。通过控制训练环境,我们让它更稳定,也更具泛化能力。
为什么这种方法此前没有在游戏中被广泛使用?
Martin Singh-Blom:因为它极其困难。
你是在机器人学研究前沿工作,这需要数年时间。我们多次几乎砍掉这个系统,因为它没有达到我们的质量门槛。关于是否应该保留它,有过很多讨论。某些阶段动画看起来不够好,这确实是实实在在的风险。
让它得以保留的是,涌现式玩法非常有价值。游戏设计师们真心相信它。最终,我们实现了一种叫做对抗性运动先验(adversarial motion priors)的方法,这让质量大幅提升。那时我们才有信心保留它。
但即便如此,仍然需要一个五到十人的团队工作数年,才达到这个程度。
你最期待进一步探索哪些领域?
Martin Singh-Blom:感知是一个很有意思的领域。
早前,我们的视觉系统无法处理室内环境。它本质上是机器人上方的一个网格,用来测量地面高度;这套方案在户外有效,但到了室内就失效了。
当我们改进这一点后,敌人突然能够在室内空间中导航,这改变了它们的行为方式,也带来了新的可能性。扩展现有敌人的能力也有很大潜力。像 leapers 这样更小、更快的敌人尤其有意思,因为移动是它们行为中非常重要的一部分。
另外还有一个长期设想,就是把这与破坏系统结合起来。我们做过实验,它确实可行,但需要对游戏做出重大改动,所以目前不在路线图中。
相关链接
原文链接:https://80.lv/articles/inside-the-magic-of-machine-learning-that-powers-enemy-ai-in-arc-raiders


喜欢这篇内容吗?