论文 / 研究阅读AuK:统一语音生成、编辑和增强的开源音频模型
AuK Technical Report: An Open-Source Foundational Model for Speech Generation and Editing
2026 · arXiv 预印本 · 腾讯混元
Ma, Ziyang、Niu, Zhikang、Tu, Wenming、Wang, Tianrui、Yan, Ruiqi、Liu, Junxi、Huo, Yanru、Huang, Nickk、等;完整作者名单见原论文
项目概览
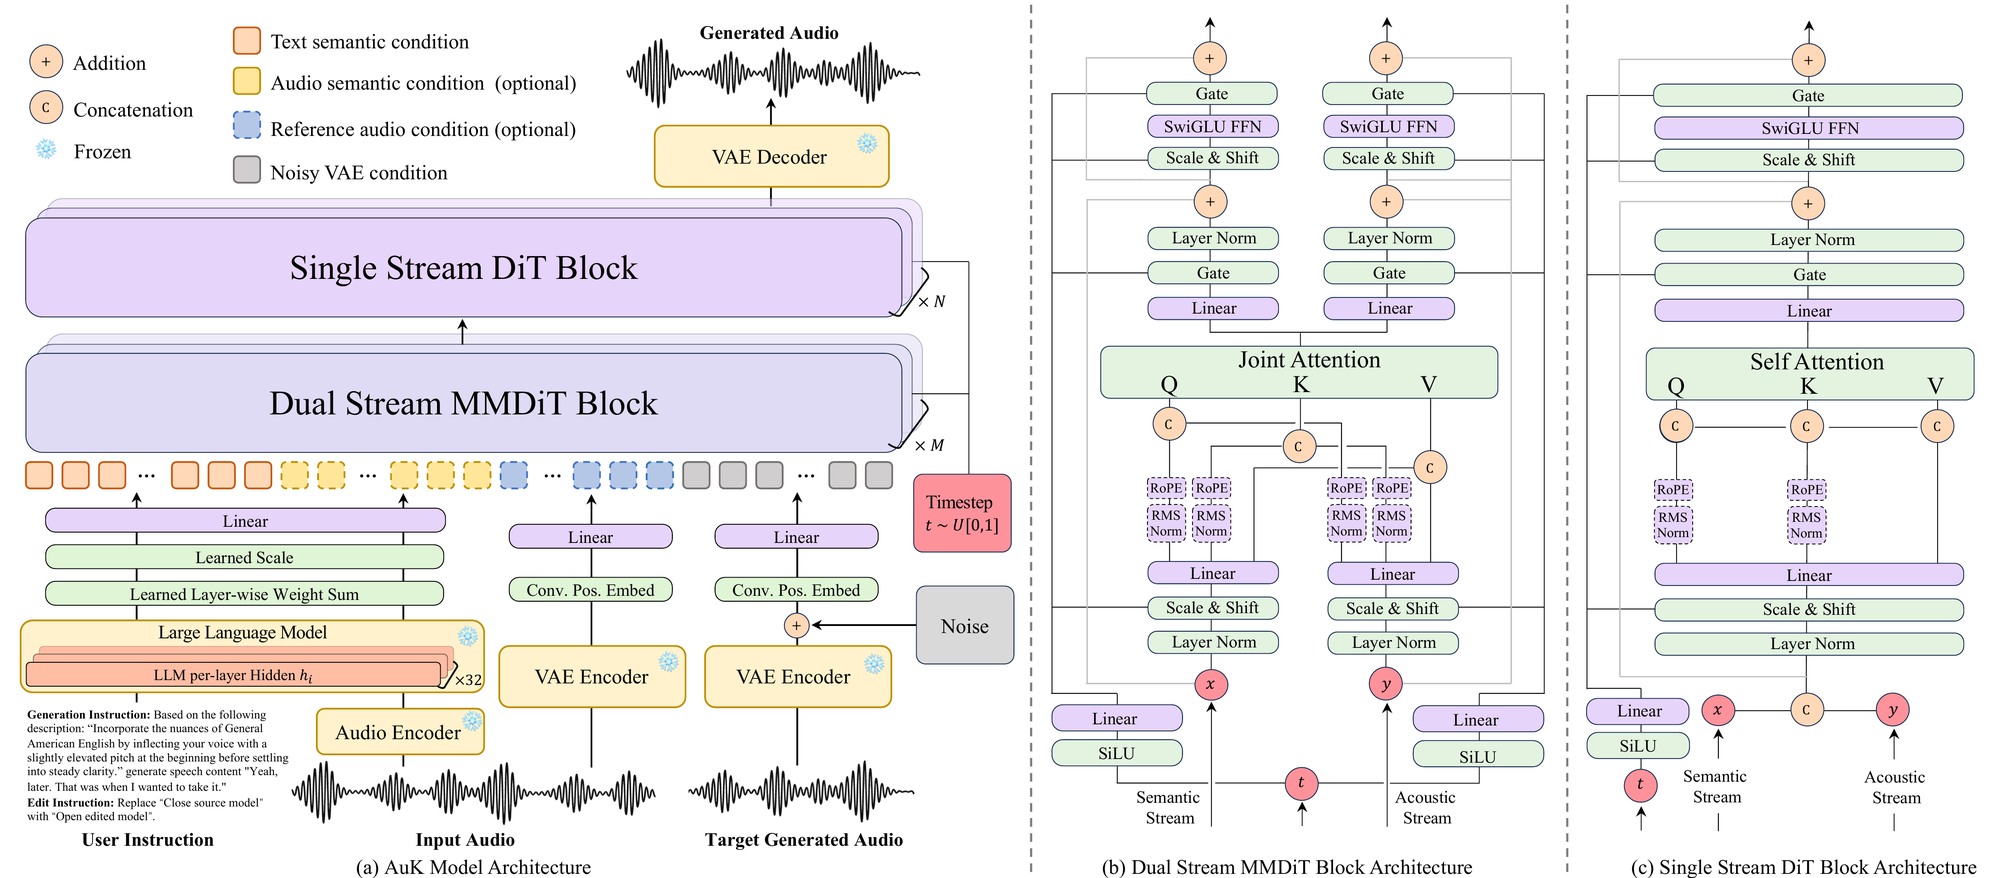
AuK 是腾讯公开的 1.5B 语音生成与编辑基础模型,以统一的自然语言指令处理多类音频任务。除了根据文字生成语音,还能参考声音做零样本 TTS、修改现有语音内容、调整音高语速音量,以及改变情绪、音色或耳语表达,对配音制作、音频修复和交互原型具有参考价值。
输入与工作流程
音频编辑任务按需要输入原始或参考音频和操作指令,输出音频文件;README 示例使用 WAV。增强与分离覆盖降噪、去混响、保留指定说话人和提取人声等。项目同时提供重质量的 AuK Base 和固定四步推理的 AuK-Flash,CLI、Python API、Gradio 界面与 ComfyUI 节点都是官方入口。
安装与运行门槛
建议建立 Python 3.10 环境,按用途安装核心、Gradio、ComfyUI 或训练依赖,并下载 AuK 权重及 Qwen2.5-Omni-3B 编码器。CUDA 支持 CPU offload;README 对特定 A800/bf16 短音频测试报告约 16.75–16.98 GiB 的卸载后峰值显存,但这不是通用最低要求,输入长度和实现版本都会影响占用。Apple Silicon 的 MLX 支持在指定分支,不能等同于所有主分支平台开箱即用。
费用、许可与使用范围
直接核心推理不以付费云 API 为前提;可选 Prompt Enhancer 需要 OpenAI 兼容 LLM 凭据,云 ASR 也有独立服务配置,不配置时存在本地 SenseVoiceSmall 回退。代码和腾讯公开的相应参数权重由 LICENSE 明确放在 MIT 下,虽 GitHub 自动识别为 Other,不能因此误写成未授权;外部编码器等依赖仍按其许可执行。语音生成和编辑应取得声音与素材授权,效果及长音频稳定性应以实际测试为准。
官方入口与使用边界
引用这篇论文
@misc{auk2026,
  title = {AuK Technical Report: An Open-Source Foundational Model for Speech Generation and Editing},
  author = {Ma, Ziyang and Niu, Zhikang and Tu, Wenming and Wang, Tianrui and Yan, Ruiqi and Liu, Junxi and Huo, Yanru and Huang, Nickk and Liu, Yang and Xie, Qicong and Xie, Zeyu and Wang, Hui and Li, Haitao and Jiang, Zixuan and Li, Yalin and Fang, Jie and Duan, Yifan and Tian, Zeyue and Li, Guangzheng and Zhu, Haina and Wang, Shuyi and Wang, Jinwen and Cui, Mingyu and Tan, Tian and Auden and Liang, Sen and Yves, Steve and Yang, Shan and Bo, Liefeng and Zheng, Zilong and Yu, Kai and Chng, Eng-Siong and Chen, Xie},
  year = {2026},
  eprint = {2609.08936},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2609.08936}
}

从你的第一条分享开始
可以聊聊实际效果、安装经验,或者你想解决的一个小问题。